go标准库——sync
sync包
go 以独特的并发编程模型闻名,其核心理念就是 ”不要以共享内存的方式来通信,而是要用通信来共享数据“ ;但大多数的现代编程语言都是用 ”共享数据内存“ 的方式来作为并发编程的解决方案。考虑开发者是有可能是从这部分编程语言转过来的,在go中也提供了类似的功能,也就是 sync 包。
一旦数据被多个线程共享,那么就很可能会产生争用和冲突的情况。这种情况也被称为竞态条件(race condition),这往往会破坏共享数据的一致性。
共享数据的一致性代表着某种约定,即:多个线程对共享数据的操作总是可以达到它们各自预期的效果。如果这个一致性得不到保证,那么将会影响到一些线程中代码和流程的正确执行,甚至会造成某种不可预知的错误。这种错误一般都很难发现和定位,排查起来的成本也是非常高的,所以一定要尽量避免。
举个例子,同时有多个线程连续向同一个缓冲区写入数据块,如果没有一个机制去协调这些线程的写入操作的话,那么被写入的数据块就很可能会出现错乱。比如,在线程 A 还没有写完一个数据块的时候,线程 B 就开始写入另外一个数据块了。显然,这两个数据块中的数据会被混在一起,并且已经很难分清了。因此,在这种情况下,我们就需要采取一些措施来协调它们对缓冲区的修改。这通常就会涉及同步。
概括来讲,同步的用途有两个,一个是避免多个线程在同一时刻操作同一个数据块,另一个是协调多个线程,以避免它们在同一时刻执行同一个代码块。
由于这样的数据块和代码块的背后都隐含着一种或多种资源(比如存储资源、计算资源、I/O 资源、网络资源等等),所以我们可以把它们看做是共享资源,或者说共享资源的代表。我们所说的同步其实就是在控制多个线程对共享资源的访问。一个线程在想要访问某一个共享资源的时候,需要先申请对该资源的访问权限,并且只有在申请成功之后,访问才能真正开始。
而当线程对共享资源的访问结束时,它还必须归还对该资源的访问权限,若要再次访问仍需申请。你可以把这里所说的访问权限想象成一块令牌,线程一旦拿到了令牌,就可以进入指定的区域,从而访问到资源,而一旦线程要离开这个区域了,就需要把令牌还回去,绝不能把令牌带走。如果针对某个共享资源的访问令牌只有一块,那么在同一时刻,就最多只能有一个线程进入到那个区域,并访问到该资源。
这时,我们可以说,多个并发运行的线程对这个共享资源的访问是完全串行的。只要一个代码片段需要实现对共享资源的串行化访问,就可以被视为一个临界区(critical section),也就是刚刚说的,由于要访问到资源而必须进入的那个区域。
它们可以是一个内含了共享数据的结构体及其方法,也可以是操作同一块共享数据的多个函数。临界区总是需要受到保护的,否则就会产生竞态条件。施加保护的重要手段之一,就是使用实现了某种同步机制的工具,也称为同步工具。
下面介绍一些在 sync 包中 go 给我们提供的同步工具
互斥锁 sync.Mutex
在 Go 语言中,可供我们选择的同步工具并不少。其中,最重要且最常用的同步工具当属互斥量(mutual exclusion,简称 mutex)。sync 包中的 Mutex 就是与其对应的类型,该类型的值可以被称为互斥量或者互斥锁。
一个互斥锁可以被用来保护一个临界区或者一组相关临界区。我们可以通过它来保证,在同一时刻只有一个 goroutine 处于该临界区之内。为了兑现这个保证,每当有 goroutine 想进入临界区时,都需要先对它进行锁定,并且,每个 goroutine 离开临界区时,都要及时地对它进行解锁。锁定操作可以通过调用互斥锁的 Lock 方法实现,而解锁操作可以调用互斥锁的 Unlock 方法。
但在使用 Mutex 时有哪些注意事项?
使用互斥锁的注意事项如下:
- 不要重复锁定互斥锁;
- 不要忘记解锁互斥锁;
- 不要对尚未锁定或者已经解锁的互斥锁解锁;
- 不要在多个函数之间直接传递互斥锁。
为什么会有这些注意事项呢?一条一条看
不要重复锁定互斥锁*
对一个已经被锁定的互斥锁进行锁定,是会立即阻塞当前的 goroutine 的。这个 goroutine 所执行的流程,会一直停滞在调用该互斥锁的Lock方法的那行代码上。直到该互斥锁的Unlock方法被调用,并且这里的锁定操作成功完成,后续的代码(也就是临界区中的代码)才会开始执行。这也正是互斥锁能够保护临界区的原因所在。
一个 goroutine 对某一个互斥锁的重复锁定,就意味着它自己锁死了自己。先不说这种做法本身就是错误的,在这种情况下,想让其他的 goroutine 来帮它解锁是非常难以保证其正确性的。
一旦,你把一个互斥锁同时用在了多个地方,就必然会有更多的 goroutine 争用这把锁。这不但会让你的程序变慢,还会大大增加死锁(deadlock)的可能性。所谓的死锁,指的就是当前程序中的主 goroutine,以及我们启用的那些 goroutine 都已经被阻塞。这些 goroutine 可以被统称为用户级的 goroutine。这就相当于整个程序都已经停滞不前了。
如果 go 语言运行时发现了死锁,会直接抛出 panic ,这种 panic 会导致程序崩溃,即使是 recover 函数也无法恢复。 因此,我们一定要尽量避免这种情况的发生。而最简单、有效的方式就是让每一个互斥锁都只保护一个临界区或一组相关临界区。
不要忘记解锁互斥锁
一个 goroutine 执行的流程中,可能会出现诸如“锁定、解锁、再锁定、再解锁”的操作,所以如果我们忘记了中间的解锁操作,那就一定会造成重复锁定。除此之外,忘记解锁还会使其他的 goroutine 无法进入到该互斥锁保护的临界区,这轻则会导致一些程序功能的失效,重则会造成死锁和程序崩溃。在很多时候,一个函数执行的流程并不是单一的,流程中间可能会有分叉,也可能会被中断。如果一个流程在锁定了某个互斥锁之后分叉了,或者有被中断的可能,那么就应该使用 defer 语句来对它进行解锁,而且这样的 defer 语句应该紧跟在锁定操作之后。这是最保险的一种做法。
忘记解锁导致的问题有时候是比较隐秘的,并不会那么快就暴露出来。这也是我们需要特别关注它的原因。相比之下,解锁未锁定的互斥锁会立即引发 panic。和死锁一样,如果出现这种情况会直接 panic 导致程序崩溃,这种错误属于知名错误,都是无法被恢复的,调用 recover 函数也无法起作用;因此,我们总是应该保证,对于每一个锁定操作,都要有且只有一个对应的解锁操作。
不要对尚未锁定或者已经解锁的互斥锁解锁
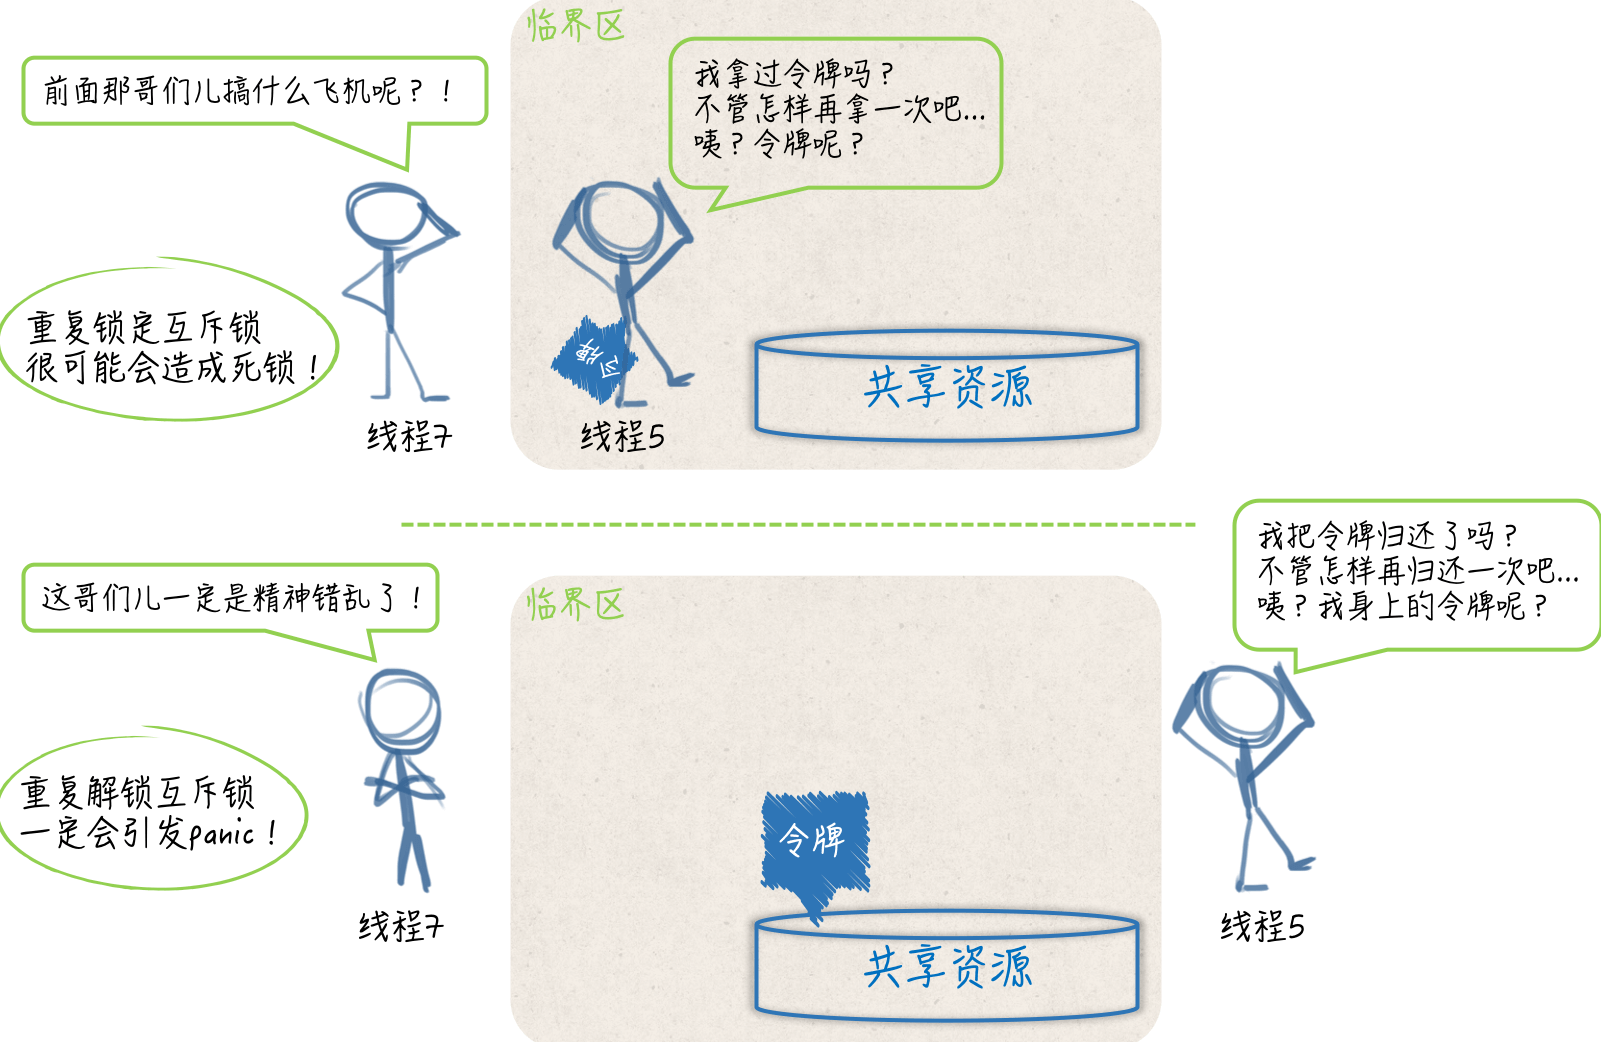
(图 互斥锁的重复锁定和重复解锁)
不要在多个函数之间直接传递互斥锁
Go 语言中的互斥锁是开箱即用的。换句话说,一旦我们声明了一个sync.Mutex类型的变量,就可以直接使用它了。
不过要注意,该类型是一个结构体类型,属于值类型中的一种。把它传给一个函数、将它从函数中返回、把它赋给其他变量、让它进入某个通道都会导致它的副本的产生。
并且,原值和它的副本,以及多个副本之间都是完全独立的,它们都是不同的互斥锁。
如果你把一个互斥锁作为参数值传给了一个函数,那么在这个函数中对传入的锁的所有操作,都不会对存在于该函数之外的那个原锁产生任何的影响。所以,你在这样做之前,一定要考虑清楚,这种结果是你想要的吗?我想,在大多数情况下应该都不是。即使你真的希望,在这个函数中使用另外一个互斥锁也不要这样做,这主要是为了避免歧义。
互斥读写锁 sync.RWMutex
读写锁是读 / 写互斥锁的简称。在 Go 语言中,读写锁由sync.RWMutex类型的值代表。与sync.Mutex类型一样,这个类型也是开箱即用的。
顾名思义,读写锁是把对共享资源的“读操作”和“写操作”区别对待了。它可以对这两种操作施加不同程度的保护。换句话说,相比于互斥锁,读写锁可以实现更加细腻的访问控制。
一个读写锁中实际上包含了两个锁,即:读锁和写锁。sync.RWMutex 类型中的 Lock 方法和 Unlock 方法分别用于对写锁进行锁定和解锁,而它的 RLock 方法和 RUnlock 方法则分别用于对读锁进行锁定和解锁。
另外,对于同一个读写锁来说有如下规则。
- 在写锁已被锁定的情况下再试图锁定写锁,会阻塞当前的 goroutine。
- 在写锁已被锁定的情况下试图锁定读锁,也会阻塞当前的 goroutine。
- 在读锁已被锁定的情况下试图锁定写锁,同样会阻塞当前的 goroutine。
- 在读锁已被锁定的情况下再试图锁定读锁,并不会阻塞当前的 goroutine。
换一个角度来说,对于某个受到读写锁保护的共享资源,多个写操作不能同时进行,写操作和读操作也不能同时进行,但多个读操作却可以同时进行。
当然了,只有在我们正确使用读写锁的情况下,才能达到这种效果。还是那句话,我们需要让每一个锁都只保护一个临界区,或者一组相关临界区,并以此尽量减少误用的可能性。顺便说一句,我们通常把这种不能同时进行的操作称为互斥操作。
读写所和互斥锁之间的区别在哪里
互斥锁,主要是保证每一时刻进入临界区的goroutine只有一个; 读写锁,对共享资源的写操作和读操作则区别看待,并消除了读操作之间的互斥。
互斥锁和读写锁区别在于,互斥锁无论是读还是写都是互斥的;而读写锁在读操作之间不互斥。
总之,读写锁与互斥锁的不同,都源于它把对共享资源的写操作和读操作区别对待了。这也使得它实现的互斥规则要更复杂一些。不过,正因为如此,我们可以使用它对共享资源的操作,实行更加细腻的控制。另外,由于这里的读写锁是互斥锁的一种扩展,所以在有些方面它还是沿用了互斥锁的行为模式。比如,在解锁未锁定的写锁或读锁时的表现,又比如,对写操作之间互斥的实现方式。
条件变量 sync.Cond
sync.Cond 条件变量用来协调想要访问共享资源的那些 goroutine,当共享资源的状态发生变化的时候,它可以用来通知被互斥锁阻塞的 goroutine。
条件变量是基于互斥锁的,它必须有互斥锁的支撑才能发挥作用,条件变量并不是被用来保护临界区和共享资源的,它是用于协调想要访问共享资源的那些线程的。当共享资源的状态发生变化时,它可以被用来通知被互斥锁阻塞的线程。
我们想象一个非常简单的场景:
有一个协程在异步地接收数据,剩下的多个协程必须等待这个协程接收完数据,才能读取到正确的数据。在这种情况下,如果单纯使用 chan 或互斥锁,那么只能有一个协程可以等待,并读取到数据,没办法通知其他的协程也读取数据。
这个时候,就需要有个全局的变量来标志第一个协程数据是否接受完毕,剩下的协程,反复检查该变量的值,直到满足要求。或者创建多个 channel,每个协程阻塞在一个 channel 上,由接收数据的协程在数据接收完毕后,逐个通知。总之,需要额外的复杂度来完成这件事。
Go 语言在标准库 sync 中内置一个 sync.Cond 用来解决这类问题。
Cond 变量的创建使用 NewCond(l Locker) 函数,该函数会传入一个 Locker 接口值,实现了该接口的类型有 sync 包的 Mutex 和 RWMutex 类型,所以说条件变量是基于互斥锁的。那条件变量是怎样与互斥锁配合使用的呢?
条件变量的初始化离不开互斥锁,并且它的方法有的也是基于互斥锁的。
条件变量提供的方法有三个:等待通知(wait)、单发通知(signal)和广播通知(broadcast)。对应的包代码如下:
1 | |
我们在利用条件变量等待通知(调用 wait 方法)的时候,需要在它基于的那个互斥锁保护下进行(也就是使用创建该条件变量时传入的互斥锁,使用该锁的 Lock 方法);
而使用单发通知( Signal )和广播通知( Broadcast )的时候恰恰相反,也就是说在该条件变量的互斥锁解锁之后才能执行这 2 个方法。
sync.Cond 如何使用?
下面经过一个例子简单说一下如何使用:
1 | |
在上面的例子中可以发现,在使用 Cond 条件变量之前需要创建一把锁,根据这把锁 Cond 才能做相关的阻塞唤醒操作;
为什么要先锁定条件变量基于的互斥锁,才能调用它的 Wait 方法?
简单的翻了一下 Wait 函数源码
1 | |
条件变量的 Wait 方法主要做了四件事:
- 把调用它的 goroutine 添加到当前条件变量的通知队列中;
- 解锁当前的条件变量基于的那个互斥锁;
- 让当前的 goroutine 处于等待状态,等到通知来时再决定是否唤醒它。此时,这个 gorouinte 就会阻塞在调用这个 Wait 方法的那行代码上;
- 如果通知到来并且决定唤醒这个 goroutine,那么就在唤醒它之后重新锁定当前条件变量基于的互斥锁。自此之后,当前的 goroutine 就会继续执行后面的代码;
在第三步中,通知来时决定是否唤醒 goroutine 的决策是根据调用 Signal 函数还是 Broadcast 函数,调用 Signal 函数则代表着唤醒最先进入通知队列的 goroutine ,如果调用 Broadcast 函数,则让通知队列上所有的 goroutine 都唤醒;
唤醒之后还要判断条件是否满足,例子中判断条件是否满足的语句就是 :for !done {},如果满足则调用 Wait 函数;不满足则就进行代码下面的操作
条件变量的Wait方法在阻塞当前的 goroutine 之前,会解锁它基于的互斥锁,所以在调用该Wait方法之前,我们必须先锁定那个互斥锁,否则在调用这个Wait方法时,就会引发一个不可恢复的 panic。
为什么条件变量的Wait方法要这么做呢?可以想象一下,如果Wait方法在互斥锁已经锁定的情况下,阻塞了当前的 goroutine,那么又由谁来解锁呢?
别的 goroutine 吗?先不说这违背了互斥锁的重要使用原则,即:成对的锁定和解锁,就算别的 goroutine 可以来解锁,那万一解锁重复了怎么办?由此引发的 panic 可是无法恢复的。
如果当前的 goroutine 无法解锁,别的 goroutine 也都不来解锁,那么又由谁来进入临界区,并改变共享资源的状态呢?只要共享资源的状态不变,即使当前的 goroutine 因收到通知而被唤醒,也依然会再次执行这个Wait方法,并再次被阻塞。所以说,如果条件变量的Wait方法不先解锁互斥锁的话,那么就只会造成两种后果:不是当前的程序因 panic 而崩溃,就是相关的 goroutine 全面阻塞。
所以要在执行 Wait 方法前都要先锁定条件变量基于的互斥锁。
为什么要用for语句来包裹调用其Wait方法的表达式,用if语句不行吗?
这主要是为了保险起见。如果一个 goroutine 因收到通知而被唤醒,但却发现共享资源的状态,依然不符合它的要求,那么就应该再次调用条件变量的Wait方法,并继续等待下次通知的到来。
条件变量的Signal方法和Broadcast方法有哪些异同?
条件变量的 Signal 方法和 Broadcast 方法都是被用来发送通知的,不同的是, Signal 方法的通知只会唤醒一个因此而等待的 goroutine,而 Broadcast 方法的通知却会唤醒所有为此等待的 goroutine。
条件变量的Wait方法总会把当前的 goroutine 添加到通知队列的队尾,而它的Signal方法总会从通知队列的队首开始,查找可被唤醒的 goroutine。所以,因Signal方法的通知,而被唤醒的 goroutine 一般都是最早等待的那一个。
这两个方法的行为决定了它们的适用场景。如果你确定只有一个 goroutine 在等待通知,或者只需唤醒任意一个 goroutine 就可以满足要求,那么使用条件变量的Signal方法就好了。否则,使用Broadcast方法总没错,只要你设置好各个 goroutine 所期望的共享资源状态就可以了。
与Wait方法不同,条件变量的Signal方法和Broadcast方法并不需要在互斥锁的保护下执行。恰恰相反,我们最好在解锁条件变量基于的那个互斥锁之后,再去调用它的这两个方法。这更有利于程序的运行效率。
原子操作 sync.atomic
原子操作(atomic operation)指的是由多步操作组成的一个操作。如果该操作不能原子地执行,则要么执行完所有步骤,要么一步也不执行,不可能只执行所有步骤的一个子集。
现代操作系统中,一般都提供了原子操作来实现一些同步操作,所谓原子操作,也就是一个独立而不可分割的操作。在单核环境中,一般的意义下原子操作中线程不会被切换,线程切换要么在原子操作之前,要么在原子操作完成之后。更广泛的意义下原子操作是指一系列必须整体完成的操作步骤,如果任何一步操作没有完成,那么所有完成的步骤都必须回滚,这样就可以保证要么所有操作步骤都未完成,要么所有操作步骤都被完成。
原子操作可以完全地消除竞态条件,并能够绝对地保证并发安全性。并且,它的执行速度要比其他的同步工具快得多,通常会高出好几个数量级。不过,它的缺点也很明显。正是因为原子操作不能被中断,所以它需要足够简单,并且要求快速。
如果一个原子操作不能被中断,但又迟迟不能完成,那么将会给计算机执行指令的效率带来多么大的影响。所以操作系统层面只针对二进制位或者证书的原子操作提供了支持。
Go 语言的原子操作基于 CPU和操作系统的,所以 Go 语言也只针对少数数据类型的值提供了原子操作函数。这些函数都存在于标准库代码包 sync/atomic 中。
sync/atomic 包中提供了几种原子操作?可操作的数据类型又有哪些?
sync/atomic 包中的函数可以作的原子操作有:加法(add)、比较并交换(compare and swap,简称 CAS )、加载(load)、存储(store)和交换(swap)。
这些函数针对的数据有:int32、int64、uint32、uint64、uintptr以及 unsafe 包的 Pointer。对这些类型中的每一个都会有原子操作的函数给予支持。比如 atomic.AddInt32 、atomic.AddUint32;
使用原子包时需要注意的点
原子操作函数的第一个函数类型是类型指针
先来看看 atomic 包中提供的原子操作函数签名:
1 | |
在这些函数签名的首个参数是指针类型,所以在传值的时候需要取地址;那这个参数的类型为什么不是 int、int32、int64而是指针呢?
因为原子操作函数需要的是被操作值的指针,而不是这个值本身;Go 语言都是传值,被传入函数的参数值都会被复制,这种基本类型的值一旦被传入函数,就已经与函数外的那个值毫无关系了。
所以传入值本身没有任何意义,只要原子操作函数拿到了被操作值的指针,就可以定位到存储该值的内存地址,只有这样才能够通过地层的指令,准确的操作这个内存地址上的数据。
原子加法操作的函数也可以做原子减法
原子加法操作函数基于操作类型分为 2 种,一种是有符号的:AddInt32、AddInt64;一种是无符号的:AddUint32、AddUint64。对于这两种操作类型有不同的原子减法操作。
对于有符号的原子操作函数,该函数的第二个传入参数类型是 int32 和 int64 ,是有符号的。如果想要做原子减法,那么把这个差量设置为负整数就可以了。例如:
1 | |
要想用atomic.AddUint32和atomic.AddUint64函数做原子减法,就不能这么直接了,因为它们的第二个参数的类型分别是uint32和uint64,都是无符号的,不过,这也是可以做到的,就是稍微麻烦一些。
总体操作就是:先把差量(比如 -1 )赋值给一个变量,然后将该变量进行类型转换成 int32 或者 int64,最后在进行类型转换转成 uint32 或者 uint64。
例如,如果想对 uint32 类型的被操作值 18 做原子减法,比如说差量是 -3,那么我们可以先把这个差量转换为有符号的 int32 类型的值,然后再把该值的类型转换为 uint32,用表达式来描述就是 uint32(int32(-3))。
1 | |
比较和交换操作与交换操作的异同
比较并操作是一个 CAS 操作,是有条件的交换操作,只有在条件满足的情况下才会进行值的交换。
那什么是条件满足呢?
就是在进行 CAS 操作的时候,函数会先判断被操作变量的当前值,是否与我们预期的旧值相等。如果相等,它就把新值赋给该变量,并返回 true 以表明交换操作已经进行;否则就忽略交换操作,并返回 false。
这种操作是一种 “乐观的操作”,总是认为被操作的资源是不会有人改变的,与“悲观锁”相反;所以 CAS 的操作会更广泛一些,可以用 for 语句联用就可以实现一种建议的自旋锁。
1 | |
在for语句中的 CAS 操作可以不停地检查某个需要满足的条件,一旦条件满足就退出for循环。这就相当于,只要条件未被满足,当前的流程就会被一直“阻塞”在这里。
这在效果上与互斥锁有些类似。不过,它们的适用场景是不同的。我们在使用互斥锁的时候,总是假设共享资源的状态会被其他的 goroutine 频繁地改变。
而for语句加 CAS 操作的假设往往是:共享资源状态的改变并不频繁,或者,它的状态总会变成期望的那样。这是一种更加乐观,或者说更加宽松的做法。
sync/atomic.Value
原子操作能完全消除竞态条件,速度比其他同步工具快的多,缺点就是只支持特定类型;若需要扩大原子操作的适用范围,Go 也提供了一种方法,那就是使用 atomic 包中的 Value。利用它可以实现对任意值进行原子性的存储与加载。
atomic.Value 结构有以下方法:
1 | |
分别对应着加载、存储、交换以及比较并交换这 4 个原子操作。
对于 Load 和 Store 方法,需要注意的是,在存储时不能存储 nil 值,且在存储一个值后就只能存储该值的类型。
在使用 Store 进行存储时,首先判断待存储值是否为 nil,若为 nil 会直接 panic 。若存储时值不为 nil ,则会判断该存储值的类型是否与之前存储值的类型一致,不一致会 panic,一致的话则存储成功。
atomic.Value 内部实际上维护的是存储值的指针,再者 Go 函数传递的都是值传递,所以在调用函数时都会对进行一次参数的拷贝。如果对一个变量存储到 Value 里面,然后在外部对该变量修改,是不会影响到 Value 里面的值。测试代码:
1 | |
在上面的代码中,baseTypeValue 变量在调用 Store 函数时将 val 变量拷贝了一份,并将该拷贝值的指针存储到内部实现中。所以后续代码在修改 val 的值后并不会影响到 baseTypeValue 内部存储的值,因为修改的并不是同一个东西。
同理,结构体的也一个道理:
1 | |
但除了值类型,还有引用类型;在把一个切片作为 Strore 函数的入参传进去时,会拷贝该切片的值,但是该值也是一个指针,该拷贝指针指向的地址与原切片是一样的,所以后续在修改切片时,Value 里面的切片数据也会被修改。
示例:
1 | |
最好不要使用atomic.Value存储引用类型的值,可能导致数据不是并发安全的。
atomic.Value 可以使用 Swap 函数进行交换,该函数要求传入一个新值并返回旧值。如果传入的新值是 nil 则会 panic,传入的新值类型与旧值类型不一致也会 panic。
atomic.Value 除了提供 Swap 函数之外还有 CompareAndSwap 函数提供比较并交换的原子操作。先来看看它的函数签名:
1 | |
该函数会传入预期旧值与新值,如果 Value 变量中存的值与预期旧值相等的话,则会将新值存储到 Value 中并返回true,否则不存储新值到 Value 返回false。
在比较之前会对预期旧值和新值做类型判断,如果传入的 2 个参数类型不一致会引发 panic;旧值、新值与 Value 所存储值的类型不一致也会引发 painc。
而如果 Value 变量还没有存储实际类型就调用了该函数,则会返回 false
示例:
1 | |
结构体也同理:
1 | |
在上面的代码中得知,再比较结构体时,只会关心结构体中每一个字段的值是否相等,每个字段相等那么这 2 个结构体对象就相等。
但还有一点需要注意的是,引用类型无法进行比较,会引发 panic。
示例:
1 | |
会引发 panic ,切片类型无法进行比较。