HBase HBase是一种数据库:Hadoop 数据库。它是一种稀疏的、分布式的、持久化的、多维度有序映射,基于行键(Row Key)、列族(columm famlies)和时间戳(timestamp)建立索引。HBase可以存储结构化和半结构化数据,也可以存储非结构化时局,不介意数据类型,允许动态的、灵活的数据模型,并不限制存储的数据的种类。
HBase 是一个开源的、分布式的、版本化的非关系型数据库,它利用 Hadoop 分布式文件系统(Hadoop Distributed File System,HDFS)提供分布式数据存储。
HBase 是一个可以进行随机访问的存取和检索数据的存储平台,存储结构化和半结构化的数据,因此一般的网站可以将网页内容和日志信息都存在 HBase 里。
如果数据量不是非常庞大,HBase 甚至可以存储非结构化的数据。它不要求数据有预定义的模式,允许动态和灵活的数据模型,也不限制存储数据的类型。
HBase 是非关系型数据库(NoSQL),它不具备关系型数据库的一些特点,例如,它不支持 SQL 的跨行事务,也不要求数据之间有严格的关系,同时它允许在同一列的不同行中存储不同类型的数据。
HBase 作为 Hadoop 框架下的数据库,是被设计成在一个服务器集群上运行的。
安装HBase 快速安装一个HBase用于开发、调试,HBase可以以3种模式运行:单机 、伪分布式 和分布式 。
伪分布式指的是在一台及其上运行多个Java进程,分别启动Hbase,模拟集群环境下多个HBase实例;
这里安装单击模式的HBase。
打开该链接 下载Hbase,这里选择 hbase-2.4.12-bin.tar.gz 版本。
构建镜像
安装HBase需要依赖Java环境,所以需要提前准备好;搭建HBase只是调试,不想产生太多文件占用电脑空间,所以我这里选择使用 docker 来搭建 HBase ,需要准备特定的环境,下面是准备好的 Dockerfile 文件
1
2
3
4
5
6
7
8
9
10
11
12
13
14
FROM ubuntu:20.04 WORKDIR COPY sources.list /etc/apt/sources.list ADD hbase-2.4.12 /root/habase-2.4.12 RUN apt upgrade -yqq RUN apt update -yqq RUN apt install openssh-server openssh-client -yqq RUN apt install default-jre -yqq RUN apt install default-jdk -yqq RUN apt install vim -yqq CMD ["/bin/bash" ]
以上Dockerfile文件的作用如下:
将一个 sources.list 替换该ubuntu系统原有的 sources.list 文件,该文件里的源是国内方便访问的阿里源;
将下载好的hbase的包拷贝到容器内,ADD命令会将一个tar的包解压
根据新源更新软件
安装ssh客户端和服务端
分别安装 vim 、openjdk 和 jre ,版本是 Java 11
使用docker命令构建镜像和创建容器:
1
2
docker build -t hbase:2.4.1 .
设置hbase配置文件
进入已经创建好的容器,根据Dockerfile里面的定义,Hbase 会解压到 /root 目录。解压后的HBase文件目录结构如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
root@1263dd90afc8:~/habase-2.4.12# tree -L 1 .
其中 bin 目录存放关于 HBase 的起停脚本以及 region 的相关脚本;conf 目录存放 HBase 的配置文件,对于该目录 单机模式下 只需要关注2个配置文件:hbase-env.sh和hbase-site.xml;lib目录是HBase所依赖的包;docs目录是相关文档html网页。
接下来就要进入 conf 目录下修改 hbase-site.xml 文件,在文件内的 configuration 标签内添加一组 property 标签,内容如下:
1 2 3 4 <property > <name > hbase.rootdir</name > <value > file:///root/hbase_data</value > </property >
该配置是设置region servers 共享的目录,用于持久化存储HBase数据,默认写入/tmp中。如果不修改此配置,在HBase重启时,数据会丢失。此处一般设置的是hdfs的文件目录。
当然还有很多其他参数可以根据需求进行设置,具体可查看官网 和官网中文文档 上的配置项。
设置完 hbase-site.xml 文件之后,接下来修改 hbase-env.sh 文件,要在该文件里面声明 Java的目录,如果不知道Java的目录指向哪里,需要使用以下命令去发现:
1
2
root@1263dd90afc8:~/habase-2.4.12/conf# whereis java
得到以上输出:/usr/bin/java ,那么就可以在 hbase-env.sh 文件内写入以下命令:
为什么不写完 /usr/bin/java ?因为这样写入再启动hbase,会提示找不到JAVA_HOME目录,HBase会在该目录上面在拼接字符串 /bin/java;
那如果在配置文件内写的是 export JAVA_HOME=/usr/ ,那么HBase会去 /usr/bin/java/bin/java 去寻找
启动HBase
设置完2个配置文件之后就可以启动 HBase 了,进入 bin 目录,执行 start-hbase.sh 脚本即可
访问 IP:160010 地址就可以看到HBase的webUI界面了
Hbase的数据模型 HBase 不支持关系模型,它可以根据用户的需求提供更灵活和可扩展的表设计。与传统的关系型数据库类似,HBase 也是以表的方式组织数据,应用程序将数据存于 HBase 的表中,HBase 的表也由行和列组成。
但有一点不同的是,HBase 有列族的概念,它将一列或多列组织在一起,HBase 的每个列必须属于某一个列族。
逻辑模型 HBase里的逻辑实体如下:
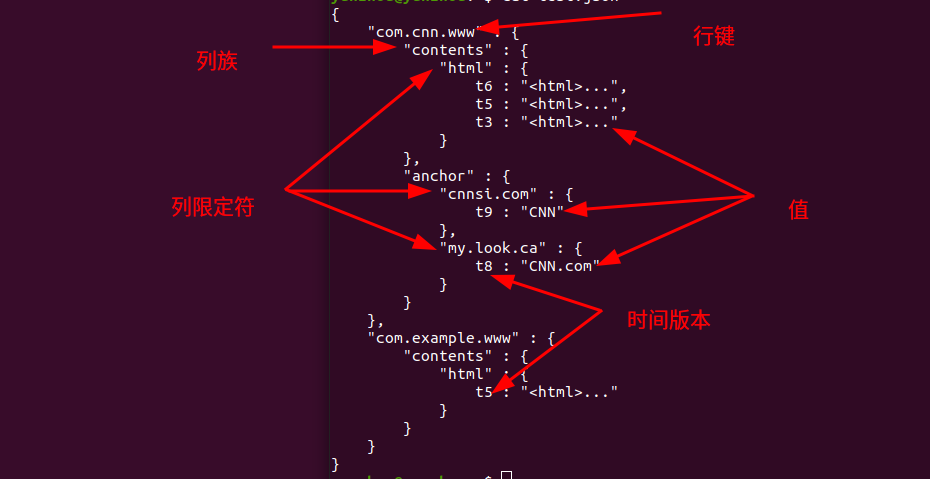
表(table) — Hbase用表来组织数据。行(row) — 在表里,数据按行来存储。行由行键(rowKey )唯一标识。行键没有数据类型,总是视为字节数组。列族(columm family) — 行里的数据按照列族来分组,列族也影响到HBase数据的物理存放 。因此它们必须事前定义并且不轻易修改 。列限定符(columm qualifier) — 列族里面的数据通过列限定符来定位,列限定符不必事前定义,不必在不同行之间保持一致。 单元格(cell) — 行键、列族和列限定符一起确定一个单元格。时间版本(version) — 单元值有时间版本,时间版本用时间戳来表示 ,是一个long。HBase保留单元值时间版本的数量基于列族进行配置,
在HBase中使用行键、列族、列限定符、时间版本 这4个维度来唯一的定位一个单元格;把这4个维度看做一个整体,HBase就可以看作是一个键值(key-value)数据库,4个维度作为Key,单元格数据作为值。
webtable 表示例:
行键
时间戳
列族 contents
列族 anchor
列族 people
“com.cnn.www”
t9
anchor:cnnsi.com = “CNN”
“com.cnn.www”
t8
anchor:my.look.ca = “CNN.com”
“com.cnn.www”
t6
contents:html = “…”
“com.cnn.www”
t5
contents:html = “…”
“com.cnn.www”
t3
contents:html = “…”
“com.example.www”
t5
contents:html = “…”
people:author = “John Doe”
有一个名为webtable的表包含两行(com.cnn.www和com.example.www)和三个列族,名为contents,anchor和people。在此示例中,对于第一行(com.cnn.www),anchor包含两列(anchor:cssnsi.com,anchor:my.look.ca),contents包含一列(contents:html)。此示例包含具有行键com.cnn.www的行的 5 个版本,以及具有行键com.example.www的行的一个版本。 contents:html列限定符包含给定网站的整个 HTML。 anchor列族的限定符每个都包含指向该行所代表的站点的外部站点的链接,以及它在其链接的anchor中使用的文本。 people列系列表示与该站点关联的人员。
生成的JSON文件如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
{ "com.cnn.www" : { "contents" : { "html" : { : "<html>..." , : "<html>..." , : "<html>..." } } , "anchor" : { "cnnsi.com" : { : "CNN" } , "my.look.ca" : { : "CNN.com" } } } , "com.example.www" : { "contents" : { "html" : { : "<html>..." } } } }
物理模型 与面向行存储的关系型数据库不同,HBase 是面向列存储的,且在实际的物理存储中,列族是分开存储的。
虽然在概念级别,表可以被视为一系列稀疏的行,但在物理意义上它们是按照列族存储的。可以随时将新的列限定符(column_family:column_qualifier)添加到现有列族中。
逻辑模型中显示的空单元格将不会占据物理存储空间。所以在示例中对时间戳 t9 处对 contents:html列的值的请求将不会返回值,因为根本就没有存储。
HBase中的记录是按照兼职对存储在HFile里面,HFile本身就是一个二进制文件,不是直接可读的。一行中一个列族的数据不一定存放在同一个HFile里,可能会分散在多个HFile里,但一行中列族的数据会物理存放和在一起。
安装集群HBase 按照集群的HBase需要安装 zookeeper集群 、Hadoop集群。
机器配置:
主机名
node1
192.168.1.238
4核
16G
500G
node2
192.168.1.239
4核
16G
500G
master
192.168.1.240
4核
16G
500G
这些机器都是在超融合服务器上创建的虚拟机,可以先在一台机器上配置好基础参数,然后进行克隆,再到具体的机器上修改一些必要配置即可。
前期准备 1. 配置主机名 根据机器配置表的内容以及ip地址配置
通过以下命令修改
1 hostnamectl set-hostname master
2. 修改hosts文件 1 2 3 4 5 6 7 8 9 10 sudo vim /etc/hosts
3. 生成密钥并设置免密登陆 1 2 3 4 5 6 7 ssh-keygen -t rsa -P ""
4. 下载好Hadoop、Zookeeper、HBase安装包 这里各个组件的版本选择如下表:
组件
版本
Java
1.8
Hadoop
2.10.1
Hbase
2.3.0
Zookeeper
3.7.1
并把这些安装包上传到机器内。
搭建Hadoop集群 1. 解压安装包 将需要安装的组件安装包上传到机器,使用以下命令解压到指定目录,这里为了方便其他用户使用,解压到 /opt 目录
1 sudo tar -zxvf hadoop-2.10.1.tar.gz -C /opt
2. 环境配置 配置 hadoop-env.sh 首先安装JDK1.8,在 /etc/profile 文件中追加以下内容,具体安装位置根据实际情况填写:
1 2 export JAVA_HOME=/opt/jdk1.8.0_331export PATH=${PATH} :${JAVA_HOME} /bin
Java的解压路径根据自己的实际情况修改
修改完之后可以通过 source /etc/profile 命令对当前终端生效,需要永久生效的话需要重启该机器。
然后在 hadoop-env.sh 文件中追加以下内容:
1 export JAVA_HOME=/opt/jdk1.8.0_331
配置 core-site.xml 在该文件中主要配置hdfs的默认节点 NameNode 和数据存放位置;
在 core-site.xml 文件中的 configuration标签中添加以下内容:
1 2 3 4 5 6 7 8 9 10 11 <property > <name > fs.default.name</name > <value > hdfs://master:9000</value > </property > <property > <name > hadoop.tmp.dir</name > <value > /opt/data/hadoop/temp</value > </property >
配置 hdfs-site.xml 在 hdfs-site.xml 文件中的 configuration标签中添加以下内容:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 <property > <name > dfs.replication</name > <value > 2</value > </property > <property > <name > dfs.namenode.http-address</name > <value > master:50090</value > </property > <property > <name > dfs.namenode.secondary.http-address</name > <value > node1:50090</value > </property > <property > <name > dfs.namenode.name.dir</name > <value > /home/yunzhou/data/hadoop/NameNode</value > </property > <property > <name > dfs.datanode.data.dir</name > <value > /home/yunzhou/data/hadoop/DataNode</value > </property >
配置 mapred-site.xml 文件 第一次配置的时候是没有 mapred-site.xml 文件的,只存在一个 mapred-site.xml.template 模板文件,我们只需要将该模板文件拷贝并重命名为 mapred-site.xml ,在这份文件里面修改即可。
1 2 cp mapred-site.xml.template mapred-site.xml
在 mapred-site.xml 文件的 configuration 标签内添加以下内容:
1 2 3 4 5 6 7 8 9 10 11 <property > <name > mapreduce.framework.name</name > <value > yarn</value > </property > <property > <name > mapreduce.jobtracker.address</name > <value > yarn</value > </property >
配置 yarn-site.xml 文件 在 yarn-site.xml 文件的 configuration 标签内添加以下内容:
1 2 3 4 5 6 7 8 9 10 11 <property > <name > yarn.resourcemanager.hostname</name > <value > master</value > </property > <property > <name > yarn.nodemanager.aux-services</name > <value > mapreduce_shuffle</value > </property >
配置 slaves 添加datanode节点
1 2 3 4 5 vim slaves
注意这里添加的记录是DataNode的主机名
3. 克隆虚拟机 因为我搭建HDFS集群的机器是虚拟机,以上步骤就是每一个节点都要的操作,所以到这里就可以克隆虚拟机。在克隆之后还需要修改以下配置就可以当作DataNode
如果是物理机器,也可以依照上面的步骤重新来一遍。
修改主机名 每一个 DataNode 节点的主机名都需要 NameNode 节点的 slaves 文件里的主机名一致
修改hosts文件 修改ip地址和主机名的映射关系
生成密钥并设置免密登陆 如果是虚拟机克隆过来的得重新生成密钥,因为克隆过来的密钥都是master节点的密钥,并不能登陆到其他节点
设置免密登陆之后需要自己手动SSH登陆测试,以确保设置成功
4. 格式化NameNode节点 使用以下命令格式化
注意,log的命令风格是Java风格,log没有WRAN和ERROR错误即可。
5. 配置Hadoop的环境变量 在 /etc/profile 中追加 Hadoop 的环境变量:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 export HADOOP=/opt/hadoopexport PATH=${PATH} :${HADOOP} /binexport PATH=${PATH} :${HADOOP} /sbincat /etc/profileexport JAVA_HOME=/opt/jdk1.8.0_331export PATH=${PATH} :${JAVA_HOME} /binexport HADOOP=/opt/hadoopexport PATH=${PATH} :${HADOOP} /binexport PATH=${PATH} :${HADOOP} /sbin
source /etc/profile 仅对当前终端生效,想要永久生效还需要重启机器。
6. 启动Hadoop集群 仅在 master 节点执行命令:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 start-all.sh
因为配置了hadoop的环境变量,所以可以执行该脚本;
相对应的想终止hadoop进程,就要使用 stop-all.sh脚本
可以看到在 master 节点有 ResourceManager、NameNode 2个进程,ResourceManager 进程是在 yarn-site.xml 文件内配置的,NameNode 进程是在 hadoop-env.sh 文件和 core-site.xml文件内配置的;
而 node1 节点的 SecondaryNameNode 进程在 hdfs-site.xml 文件内配置;node2 和 node1的 DataNode 进程是在 master 节点的 slaves文件配置。
6. 查询集群状态 命令行查看简要信息 使用以下命令可以简单查询集群信息:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 hdfs dfsadmin -reportfactor 1): 0
web页面查看信息 根据 ip:port去访问web管理界面,ip地址为master节点的地址,port在 core-site.xml 配置文件dfs.namenode.http-address 配置项的值;
至此,Hadoop存储集群就搭建完成,想要存储数据得要搭建HBase集群,通过Hbase来存储数据。
搭建Zookeeper集群 Zookeeper 用的版本是 3.7.1
1. 解压缩安装包 使用以下命令解压安装包,解压到 /opt 目录下
1 tar -zxvf apache-zookeeper-3.7.1-bin.tar.gz -C /opt
2. 配置环境变量 在 /etc/profile 配置文件追加以下内容:
1 2 3 4 5 vim /etc/profileexport ZK=/opt/zookeeperexport PATH=${PATH} :${ZK} /bin
source /etc/profile 仅对当前终端生效,想要永久生效还需要重启机器。
3. 修改配置文件 配置文件目录是在{zk安装目录}/conf下,默认是只有 zoo_sample.cfg 文件,所以我们需要拷贝一份并在这份文件上面修改。
1 cp zoo_sample.cfg zoo_sample.cfg
配置文件有以下内容:
配置项
值
描述
tickTime
2000
Zookeeper服务器之间或者客户端与服务器之间维持心跳的时间间隔
initLimit
10
配置zk接受客户端初始化连接时最长能忍受多少个心跳时间间隔(如果为10,那就最长忍受10 * 2000毫秒的心跳时间)
maxClientCnxns
0
单个客户端与单台服务器之间的连接数量限制,默认值是60,如果值为0代表不做限制
syncLimit
5
Leader与Follower之间发送消息、请求和应答时间长度最长不能超过多少个 tickTime 的时间长度
dataDir
zk保存数据的目录
clientPort
2181
客户端连接服务器的端口,默认值是2181
server.A=B:C:D
A是一个数字,表示这个是第几号服务器,B是服务器IP地址,C和D分别代表端口,这里通常是2888和3888,分别代表选举端口和心跳端口
想要心跳间隔2秒、初始化连接超时时间是20秒、节点之间发送消息超市时间是10秒、客户端与服务端连接数量不做限制,配置文件是这样
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 yunzhou@node2:~$ cat /opt/zookeeper/conf/zoo.cfg
4. 配置节点id 在 zoo.cfg 配置文件中需要指定server.id,这个id需要在 dataDir 指定的目录下创建一个名称为 myid 的文件,该文件的内容就是当前 Zookeeper 节点的id
这个id尽量与 zoo.cfg 配置文件中的 server.A:B:C 这一部分保持一致
1 2 3 4 echo 3 > /home/yunzhou/data/zookeeper/myidcat /home/yunzhou/data/zookeeper/myid
注意,每一个zk节点的id一定要不一致。
5. 启动集群 在每一个zk节点上运行以下命令:
1 2 3 4 5 6 zkServer.sh start
然后使用以下命令查看该节点在集群中的角色:
1 2 3 4 5 6 7 zkServer.sh statusfalse .
至此,zk集群启动成功。
搭建HBase集群 1. 解压缩安装包 使用以下命令解压安装包,解压到 /opt 目录下
1 tar -zvxf hbase-2.3.0-bin.tar.gz -C /opt
2. 设置环境变量 在 /etc/profile 配置文件追加以下内容:
1 2 3 4 5 vim /etc/profileexport HBASE=/opt/hbaseexport PATH=${PATH} :${HBASE} /bin
source /etc/profile 仅对当前终端生效,想要永久生效还需要重启机器。
3. 设置配置文件 修改位于 hbase安装目录conf目录的 hbase-site.xml 配置文件,在 configuration 标签下覆盖以下内容:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 <property > <name > hbase.cluster.distributed</name > <value > true</value > </property > <property > <name > hbase.tmp.dir</name > <value > /home/yunzhou/data/hbase/temp</value > </property > <property > <name > hbase.rootdir</name > <value > hdfs://master:9000/home/yunzhou/data/hbase/root</value > </property > <property > <name > hbase.master</name > <value > master:6000</value > </property > <property > <name > hbase.zookeeper.quorum</name > <value > master,node1,node2</value > </property >
4. 设置 regionservers 在conf目录下的regionservers 文件写入地址
1 2 3 4 cat regionservers
5. 启动HBase集群 执行以下命令用于启动HBase集群:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 start-hbase.shin [jar:file:/opt/hadoop/share/hadoop/common/lib/slf4j-log4j12-1.7.25.jar!/org/slf4j/impl/StaticLoggerBinder.class]in [jar:file:/opt/hbase/lib/client-facing-thirdparty/slf4j-log4j12-1.7.30.jar!/org/slf4j/impl/StaticLoggerBinder.class]for an explanation.type [org.slf4j.impl.Log4jLoggerFactory]in [jar:file:/opt/hadoop/share/hadoop/common/lib/slf4j-log4j12-1.7.25.jar!/org/slf4j/impl/StaticLoggerBinder.class]in [jar:file:/opt/hbase/lib/client-facing-thirdparty/slf4j-log4j12-1.7.30.jar!/org/slf4j/impl/StaticLoggerBinder.class]for an explanation.type [org.slf4j.impl.Log4jLoggerFactory]
使用 jps 命令来查看 HBase 的进程有没有起来:
1 2 3 4 5 6 164307 NameNode
有看到 HMster 和 HRegionServer 这2个进程起来就代表 HBase 启动成功。