Go的map
Go 中的 map
Go 语言的 map 底层使用 Hash 表实现,先来看看在 Go 中如何使用 map。
初始化
map 分别支持字面量初始化和内置函数 make()初始化。
字面量初始化:
1 | |
内置函数 make()初始化:
1 | |
使用 make()函数初始化时可以同时指定 map 的容量(也可以不指定)。指定容量可以有效地减少内存分配的次数,有利于提升应用性能。
增删改查
map 的增删改查操作比较简单,如下所示:
1 | |
需要注意的是,在上面的修改操作中,如果键“aplle”不存在,则 map 回创建一个新的键值对并存储,等同于添加新的元素。
删除元素使用内置函数 delete()完成,delete()没有返回值,在 map 为 nil 时或者指定的键不存在的情况下,delete()不会报错,相当于空操作。
在查询操作中,最多可以给两个变量赋值,第一个为值,第二个为 bool 类型的变量,用于指示是否存在指定的键,如果键不存在,那么第一个值为相应类型的零值。如果只指定一个变量,那么该变量仅表示该键对应的值,如果键不存在,那么该值为相应类型的零值。
内置函数 len()可以查询 map 的长度,该长度反映 map 中存储的键值对数。
注意,map 的操作并不是原子的,意味着多个携程同时操作 map 时会有读写冲突,触发 panic。
未经过初始化的 map 的值为 nil,如果往 nil 的 map 添加元素会触发 panic,但查询、删除操作不会报错。
map 的实现原理
数据结构
Go 中的 map 使用 Hash 表作为底层实现,一个 Hash 表有多个 bucket,而每个 bucket 保存了 map 中的一个或者一组键值对,每个 bucket 可以存储 8 个键值对。
1)数据结构
map 的数据结构由 runtime/map.go:hmap 定义:
1 | |
下图展示了一个拥有 4 个 backet 的 map。
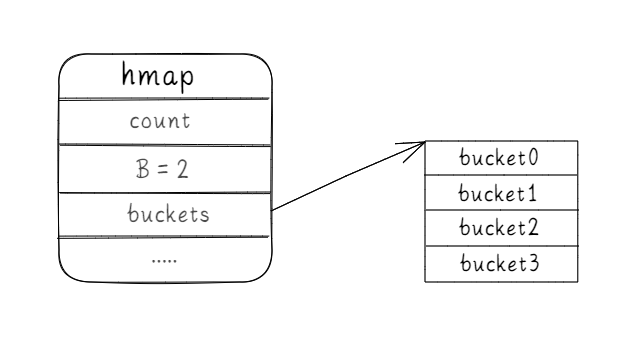
本例子中,hmap 的 B = 2,hmap.backets 的数组长度是 4。元素经过 Hash 函数运算后会落到某一个 backet 中存储。
2)backet 的数据结构
buckets 数组中存储的结构体由 runtime/map.go:bmap 定义:
1 | |
但这只是“表面”结构,编译器会给它“加料”,动态地创建一个新的结构:
1 | |
下面是一个 bucket 的示意图
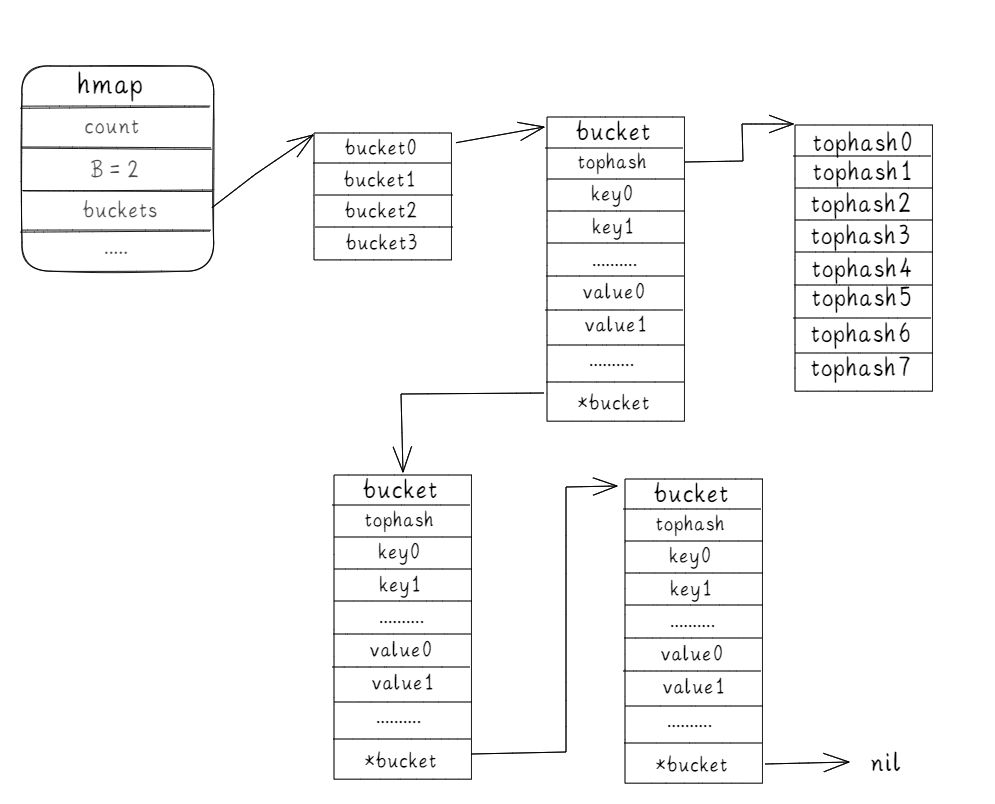
从上面也能看出,key 和 value 是各自放在一起的,并不是 key/value/key/value.. 这样的形式。这样做是为了节省字节对齐带来的空间浪费。如果按照 key/value/key/value.. 这样的模式存储,那再每一个 key/value 对之后都要额外的对齐 7 个字节,而使用 key/key/key/value/value/value ,则只需要再最后字节对齐。
一个 bamp 只能装 8 个键值对,如果由第 9 个 key-value 落入当前的 bucket,则需要再构建一个 bucket,并且通过 overflow 指针连接起来,这就是所谓的拉链法。
负载因子
负载因子用于衡量一个 Hash 表的冲突情况,公式为:
负载因子 = 键数量 / bucket 数量
例如,对于一个 bucket 数量为 4,包含 4 个键值对的 Hash 表来说,这个 Hash 表的负载因子为 1。
负载因子过小或者过大都不理想:
- 负载因子过小,说明空间利用率低;
- 负载因子过大,说明冲突严重,存取效率低。
负载因子过小,可能是预分配的空间太大,也有可能是大部分元素被删除造成的。随着元素不断添加到 map 中,负载因子会逐渐升高。
当 Hash 表的负载因子过大时,需要申请更多的 bucket,并对所有的键值对进行重新组织,让其均匀地分布到这些 bucket 中,这个过程叫做 rehash。
而 Go 语言的 map 则在负载因子达到 6.5 的时候才会触发 rehash。
map 的扩容
1)扩容条件
降低负载因子常用的手段是扩容,触发扩容需要满足以下任意一个条件:
- 负载因子大于 6.5 时
- overflow 的数量过多:2 的 min(15,B)对数。
- 当 B < 15,也就是 bucket 总数 2^B 小于 2^ 15 时,overflow 的 bucket 数量超过 2^B
- 当 B >= 15,也就是 bucket 总数 2^B 大于等于 2^15,overflow 的 bucket 数量超过 2^15
2)增量扩容
当负载因子过大时,就熙年间一个 bucket 数组,新的 bucket 数组的长是原来的 2 倍,然后旧 bucket 数组中的数据搬迁到新的 bucket 数组中。
考虑到如果 map 存储了很多的键值对,那么一次性搬迁会造成很大的延时,所以 Go 采用了逐步搬迁策略,即每次访问 map 时都会触发一次搬迁,每次搬迁 2 个键值对。
扩容时的处理非常巧妙,还记得之前 map 的数据结构 runtime/map.go:hmap 中的 oldbuckets 字段吗?
先让 hmap 数据结构中的 oldbuckets 成员字段指向原 buckets 数组,然后申请新的 bucket 数组,长度是原来的两倍,并且将新数组的指针保存到 hmap 数据结构的 buckets 字段中。
这样旧完成了新老 buckets 数组的交接。
key 的插入和查找
无论是元素的添加还是查询操作,都需要先根据键的 Hash 值来确定一个 bucket,并查询该 bucket 中是否存在指定的键。
- 对于查询操作而言,查到指定的键后获取值并返回,否则返回对应类型的零值
- 对于添加操作而言,查到指定的键意味着当前的添加操作实际上是更新操作,否则在 bucket 中查找一个空余位置并插入。
Key 经过 Hash 函数计算后得到 Hash 值,共 64 个 bit 位(针对 64 位机,32 位机不列入讨论,现在主流都是 64 位机器),但要计算这个 Key 到底要落入到哪一个 bucket 时,只会用到最后 B 个 bit 位。
还记得前面 map 的数据结构 runtime/map.go:hmap 中的 B 字段吗?如果 B=5,那么桶的数量也就是 buckets 数组的长度为 2^5=32。
例如,现在有一个 Key 在经过 Hash 函数计算后,得到的 Hash 值如下:
1 | |
B=5,所以用最后的 5 个 bit 位,即 00110,转换为十进制,值为 6,所以该 Key 会落入到 6 号桶,也就是buckets[6]位置。
然后再取 Hash 值的 8 位,找到此 Key 在 bucket 中的槽位,也就是 bucket 结构中的 tophash 字段。
因为根据后 B 个 bit 位来决定 key 落入的 bucket 编号,在根据高 8 位之后在 bucket 的 tophash 槽位去定位,如果有多个 key 都通过 B 个 bit 和高 8 位获得了同一个值,那就发生了冲突。当两个不同的 key 落在同一个桶中并且 tophash 值一样,也就发生了哈希冲突。冲突的解决手段是用链表法:在 bucket 中,从前往后找到第一个空位,放入新加入的有冲突的 key。之后,在查找某个 key 时,先找到对应的桶,再去遍历 bucket 中所有的 key。
如果在 bucket 中没找到,并且 overflow 不为空,还要继续去 overflow bucket 去寻找,直到找到或者所有的槽位都找遍了,仍然没有找到,返回该类型的零值。
1)查找过程
查找过程简述如下:
- 根据 Key 值计算 Hash 值
- 取 Hash 值低 B 位来确定 bucket 桶编号
- 去 Hash 值高 8 位,在 bucket 的 tophash 位置查询
- 如果
tophash[i]中存储的 Hash 值与当前 Key 的 Hash 值相等,则获取tophash[i]的 Key 值进行比较- 如果相等,则返回对应的 vlue
- 如果不相等,则查找下一个空余位置;如果当前 bucket 找不到并且 overflow 不为空,则依次去溢出的 bucket 去查找
如果当前 map 处于搬迁过程中,那么查找时优先从 oldbuckets 数组中查找,不再从新的 buckets 数组中查找。
另外,如果查找不到,也不会返回 nil,而是返回对应类型的零值。
2)添加过程
新元素添加过程:
- 根据 Key 算出 Hash 值
- 取 Hash 值的低 B 位确定 bucket 桶编号
- 查找该 Key 是否已经存在,如果存在则直接更新值
- 如果该 Key 不存在,则从该 bucket 中寻找空余位置插入
如果当前 map 处于搬迁过程中,那么新元素会直接添加到新的 buckets 数组中,但查找过程仍从 oldbuckets 数组中开始。
更新操作实际上是添加操作的特殊情况,如果元素不存在,则更新操作实际上等同于添加操作。
3)删除过程
删除元素实际上先查找元素,如果元素存在则把元素从相应的 bucket 中清楚,如果不存在则什么也不做。