树
树
树一种非常重要的非线性数据结构。树一般是描述具有层次结构的数据。在层次化的数据之间可能有祖先-后代、上级-下属、整体-部分以及其他类似的关系。
树的概念
在现实生活中,存在很多可用树形结构描述的实际问题。例如,某家族的血统关系如下:张宇有4个孩子,分别是张山、张川、张星、张月;张山有两个孩子张冰和张雪两个孩子;张星有三个孩子张雨、张云和张风;张雨有两个孩子张亮和张丽。
这个家庭关系可以很自然地用下图的树形结构来描述:
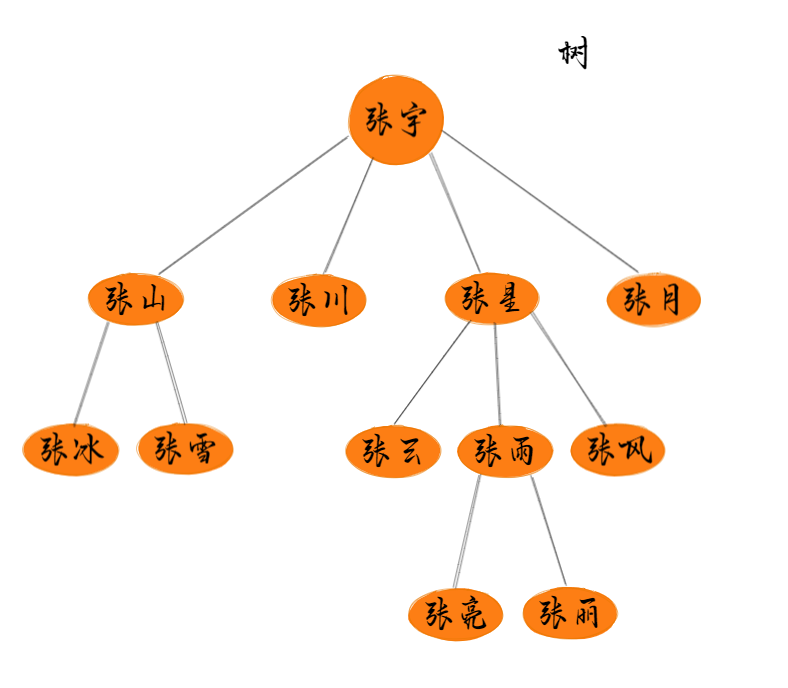
树根是张宇,树的分支结点有张山、张星和张雨,其余成员都是树叶。
在讨论树时,经常会用到一下用语:
- 结点:在书中每一个数据元素以及指向其子树根的分支称为一个结点;
- 结点的度:一个结点的子树数目称为该结点的度。例如在张宇图中,张宇的度为4,张山的度为2,张川的度为0。
- 终端结点:也可以叫做叶子结点,在树中度为0的结点称为终端结点或者叶子结点。在张宇树中:张雪、张云、张川、张月、张风、张亮、张丽都是叶子结点。
- 非终端结点:顾名思义,在树中度不为0的结点称为非终端结点或者非叶子结点。
- 树的度:树的结点中,最大的度称为该树的度。在张宇树种,其度为4。
- 孩子和双亲:树中结点p的子树的根称为结点p的孩子;反之这个节点称为其孩子的双亲。在张宇树中,张云为张星子树的根,因此张云是张星的孩子,而张星是张云的双亲结点。
- 兄弟:树中双亲相同的节点之间互称为兄弟。例如张宇树中,张山、张川、张星、张月互为兄弟结点。
- 祖先:树中从根节点到结点x所经过的分支上的所有结点称为结点x的祖先。例如张宇树中,张亮的祖先结点为张宇、张星、张雨。
- 子孙:树中以某结点p为根的子树中的所有结点都称为结点p的子孙。例如张宇树中,张山的子孙结点有张冰、张雪。
- 结点的层次:在树中,从根结点开始,根为第一层,根的孩子第二层,以此类推,树中任一结点的层次是其双亲结点层次数加1。例如张宇树中,张亮的层次数为4。
- 堂兄弟:在树中,同一个层次的结点互称为堂兄弟。例如在张宇树中,张雪、张云互为堂兄弟。
- 树的深度:树中结点的最大层次为树的深度或者树的高度,例如张宇树的深度为4。
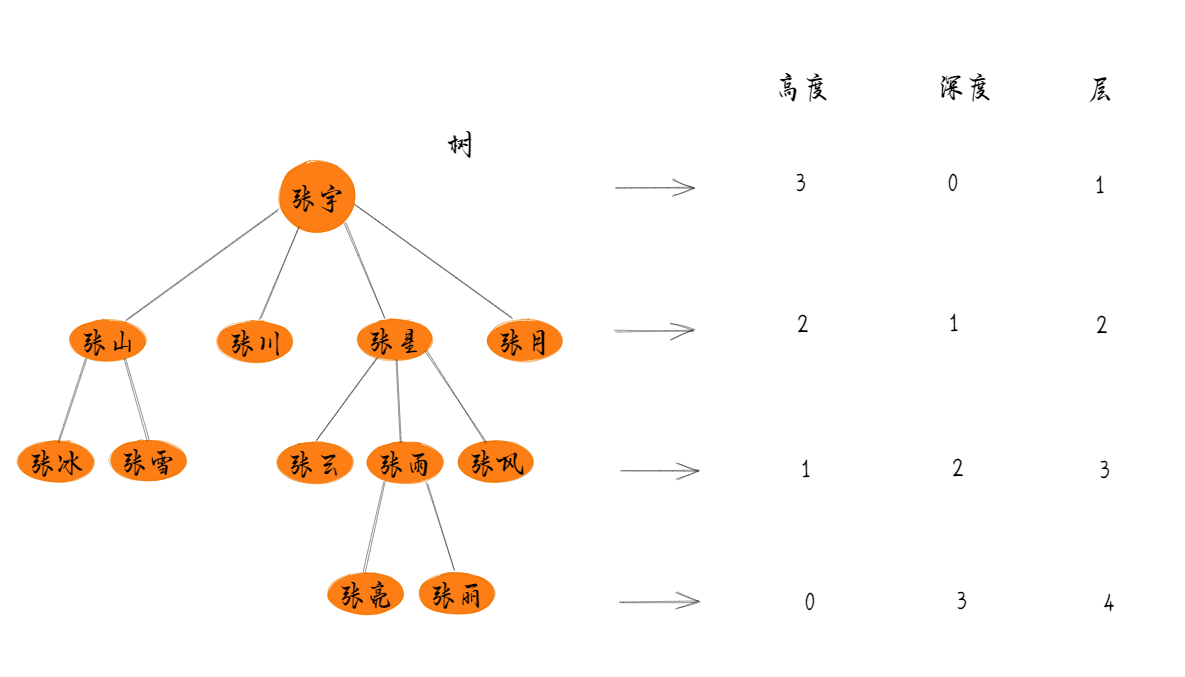
可以将一些专业术语去类比生活中的一些例子,在我们的生活中,“高度”这个概念,其实就是从下往上度量,比如我们要度量第 10 层楼的高度、第 13 层楼的高度,起点都是地面。所以,树这种数据结构的高度也是一样,从最底层开始计数,并且计数的起点是 0。
“深度”这个概念在生活中是从上往下度量的,比如水中鱼的深度,是从水平面开始度量的。所以,树这种数据结构的深度也是类似的,从根结点开始度量,并且计数起点也是 0。
“层数”跟深度的计算类似,不过,计数起点是 1,也就是说根节点位于第 1 层。
二叉树
树结构多种多样,不过我们最常用还是二叉树。
二叉树,顾名思义,每个节点最多有两个“叉”,也就是两个子节点,分别是左子节点和右子节点。不过,二叉树并不要求每个节点都有两个子节点,有的节点只有左子节点,有的节点只有右子节点。我画的这几个都是二叉树。以此类推,你可以想象一下四叉树、八叉树长什么样子。
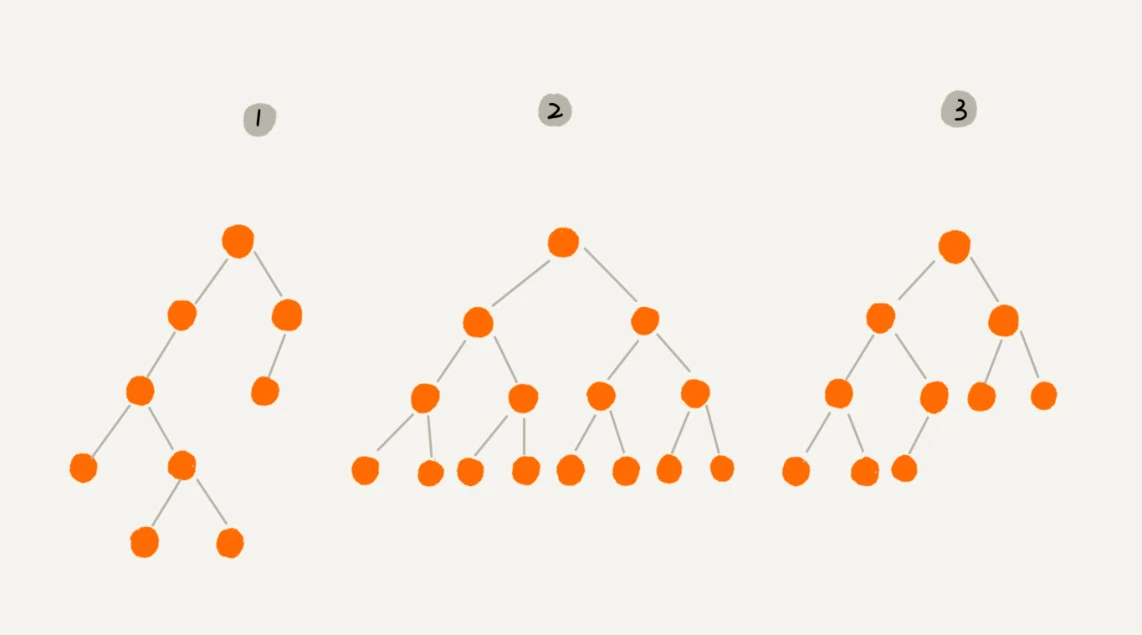
这个图里面,有两个比较特殊的二叉树,分别是编号 2 和编号 3 这两个。
其中,编号 2 的二叉树中,叶子节点全都在最底层,除了叶子节点之外,每个节点都有左右两个子节点,这种二叉树就叫做满二叉树。
编号 3 的二叉树中,叶子节点都在最底下两层,最后一层的叶子节点都靠左排列,并且除了最后一层,其他层的节点个数都要达到最大,这种二叉树叫做完全二叉树。
满二叉树很好理解,也很好识别,但是完全二叉树,有的人可能就分不清了。我画了几个完全二叉树和非完全二叉树的例子,你可以对比着看看。
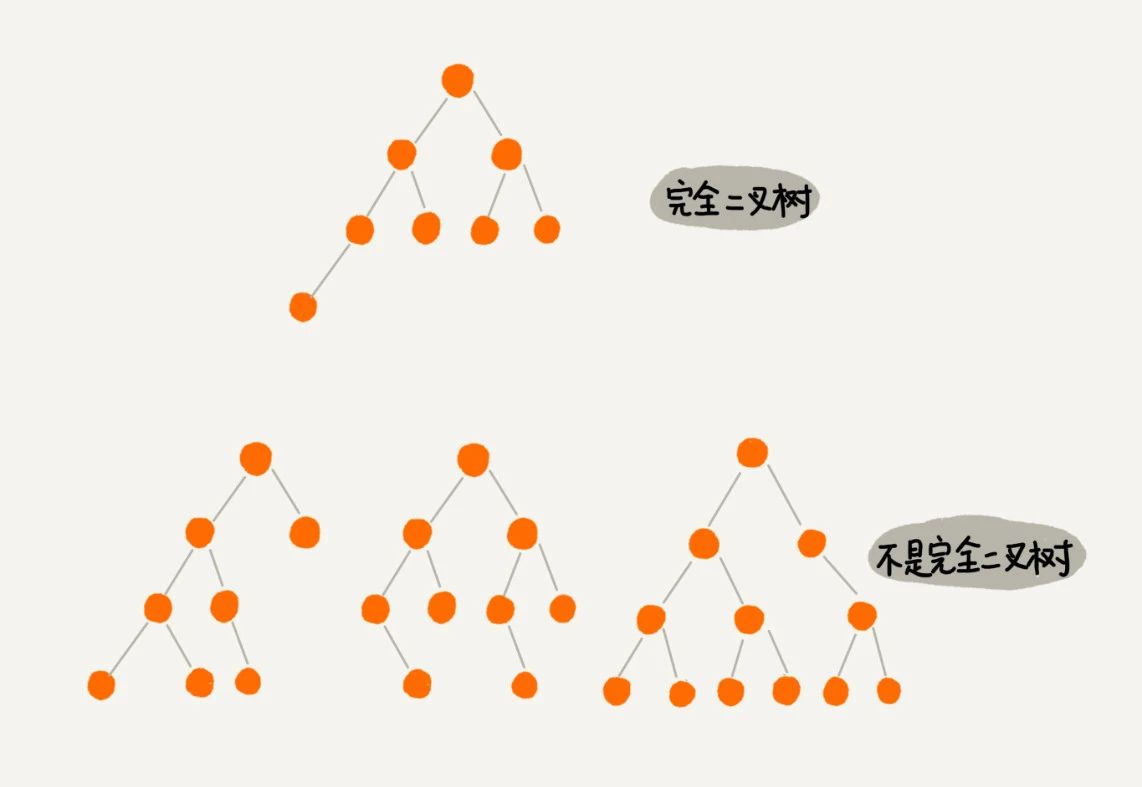
二叉树的特征非常明显,我们把它单独拎出来讲,这个可以理解。但是完全二叉树的特征不怎么明显啊,单从长相上来看,完全二叉树并没有特别特殊的地方啊,更像是“芸芸众树”中的一种。
那我们为什么还要特意把它拎出来讲呢?为什么偏偏把最后一层的叶子节点靠左排列的叫完全二叉树?如果靠右排列就不能叫完全二叉树了吗?这个定义的由来或者说目的在哪里?
要理解完全二叉树定义的由来,我们需要先了解,如何表示(或者存储)一棵二叉树?
想要存储一棵二叉树,我们有两种方法,一种是基于指针或者引用的二叉链式存储法,一种是基于数组的顺序存储法。
先来看比较简单、直观的链式存储法。从图中可以很清楚地看到,每个节点有三个字段,其中一个存储数据,另外两个是指向左右子节点的指针。我们只要拎住根节点,就可以通过左右子节点的指针,把整棵树都串起来。这种存储方式我们比较常用。大部分二叉树代码都是通过这种结构来实现的。
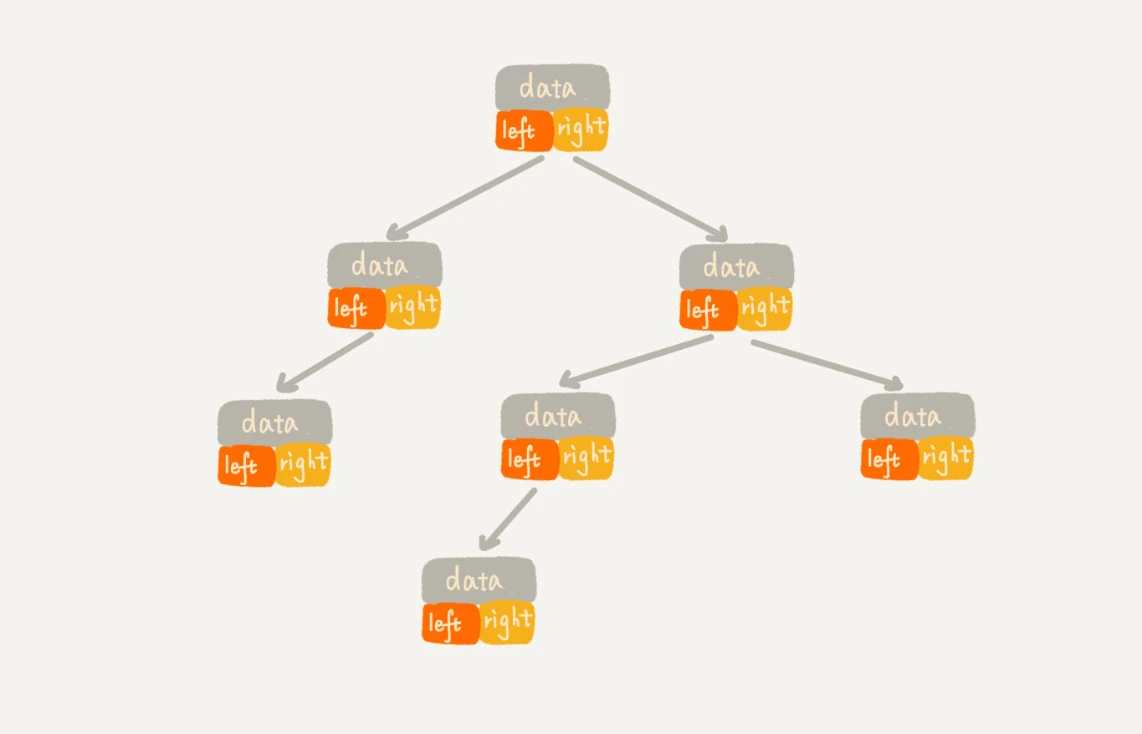
我们再来看,基于数组的顺序存储法。
我们把根节点存储在下标 i = 1 的位置,那左子节点存储在下标 2 * i = 2 的位置,右子节点存储在 2 * i + 1 = 3 的位置。以此类推,B 节点的左子节点存储在 2 * i = 2 * 2 = 4 的位置,右子节点存储在 2 * i + 1 = 2 * 2 + 1 = 5 的位置。
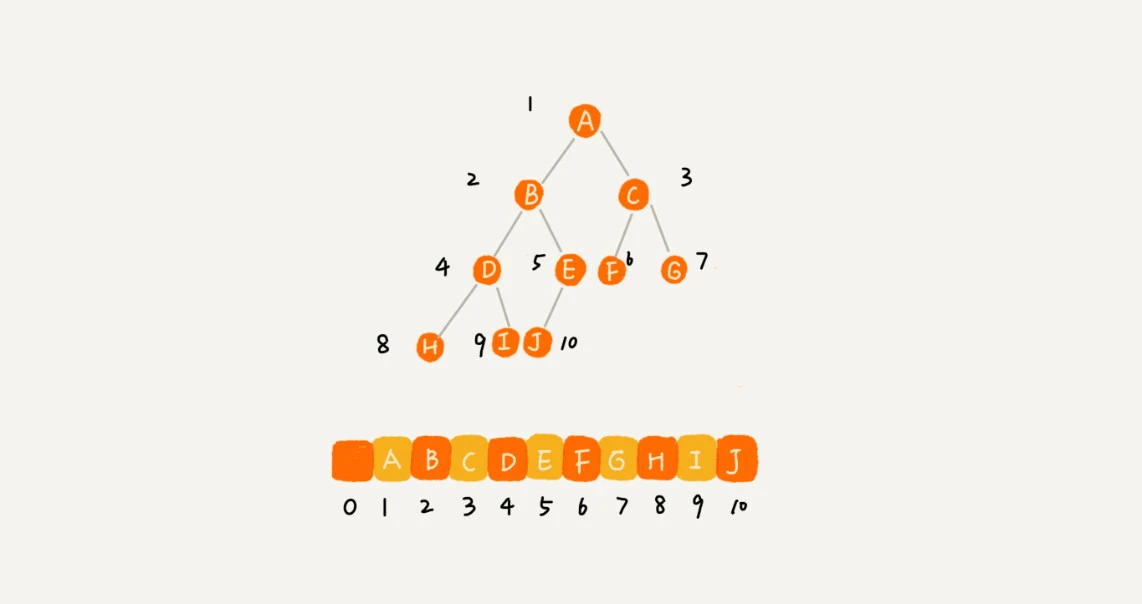
那么就可以得出结论,如果节点 X 存储在数组中下标为 i 的位置,下标为 2 * i 的位置存储的就是左子节点,下标为 2 * i + 1 的位置存储的就是右子节点。
反过来,下标为 i/2 的位置存储就是它的父节点。通过这种方式,我们只要知道根节点存储的位置(一般情况下,为了方便计算子节点,根节点会存储在下标为 1 的位置),这样就可以通过下标计算,把整棵树都串起来。
如果某棵二叉树是一棵完全二叉树,那用数组存储无疑是最节省内存的一种方式。因为数组的存储方式并不需要像链式存储法那样,要存储额外的左右子节点的指针。这也是为什么完全二叉树会单独拎出来的原因,也是为什么完全二叉树要求最后一层的子节点都靠左的原因。
二叉树的遍历
来看二叉树中非常重要的操作,二叉树的遍历。这也是非常常见的面试题。
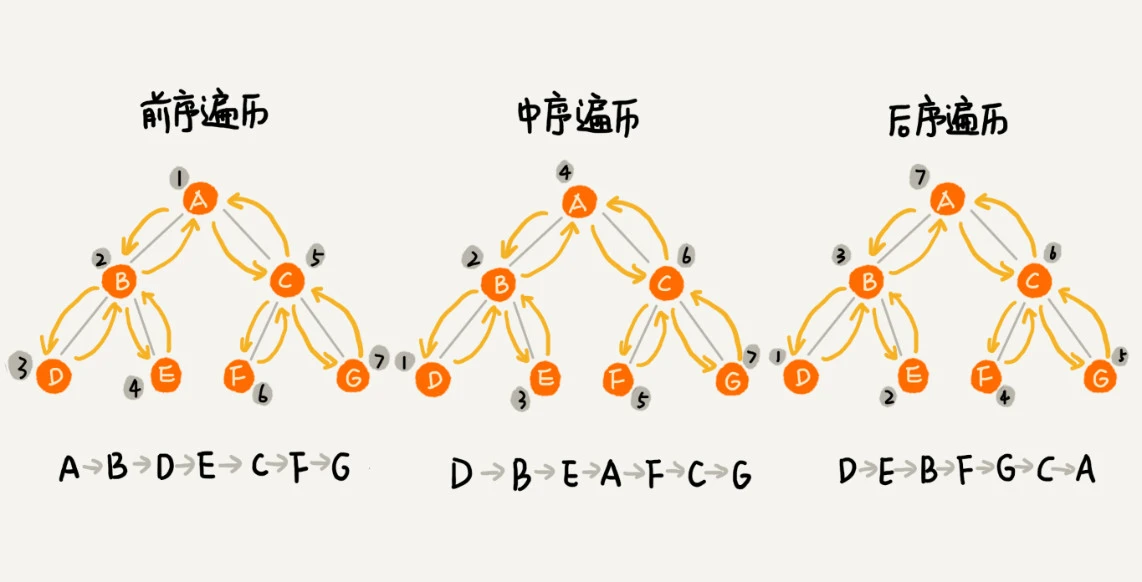
如何将所有节点都遍历打印出来呢?经典的方法有三种,前序遍历、中序遍历和后序遍历。其中,前、中、后序,表示的是节点与它的左右子树节点遍历打印的先后顺序。
前序遍历是指,对于树中的任意节点来说,先打印这个节点,然后再打印它的左子树,最后打印它的右子树。
中序遍历是指,对于树中的任意节点来说,先打印它的左子树,然后再打印它本身,最后打印它的右子树。
后序遍历是指,对于树中的任意节点来说,先打印它的左子树,然后再打印它的右子树,最后打印这个节点本身。