堆
堆
堆是树的一种变种,应用场景非常多,最经典的就是堆排序。堆排序是一种原地的、时间复杂度为 O(n log n ) 的排序算法。
如何理解“堆”
堆是一种特殊的树,但什么样的树才是堆呢?一棵树满足了以下两点要求,这颗树就是一个堆:
- 堆是一个完全二叉树
- 堆中每一个节点的值都必须大于等于(或者小于等于)其子树中每个节点的值。
第一点,堆必须是一个完全二叉树。完全二叉树要求除了最后一层,其他层的节点个数都是满的,而且最后一层的节点都靠左排列。
第二点,堆中的每一个节点的值都必须大于等于(或者小于等于)其子树中每个节点的值。
换一种说法,对于每个节点的值都大于等于子树中每个节点值的堆,叫做大顶堆。对于每个节点的值都小于等于子树中每个节点值的堆,叫做小顶堆。
具体示例看下图:
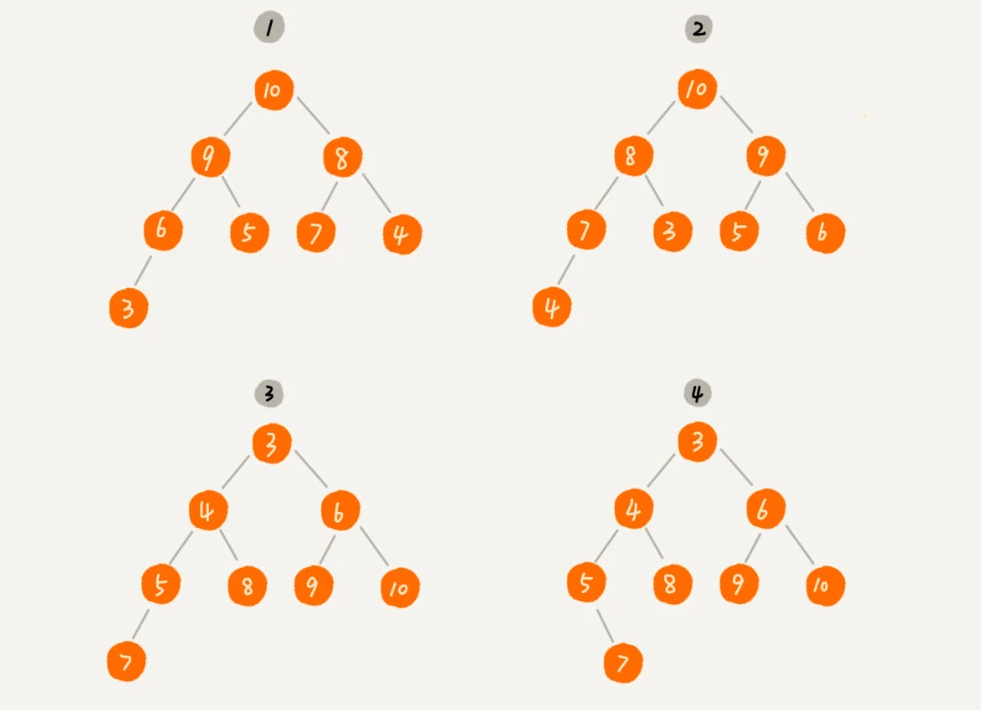
其中第1个和第2个是大顶堆,第3个是小顶堆,第4个不是堆因为不是完全二叉树。
如何实现一个堆
要实现一个堆,但先要知道,堆都支持哪些操作以及如何存储一个堆。
完全二叉树比较适合用数组来存储。用数组来存储完全二叉树是非常节省存储空间的。因为我们不需要存储左右子节点的指针,单纯地通过数组的下标,就可以找到一个节点的左右子节点和父节点。下图是用数组存储堆的例子:
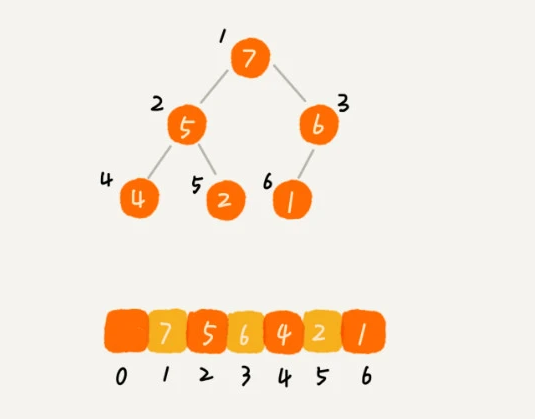
从图中我们可以看到,数组中下标为 i 的节点的左子节点,就是下标为 i∗2 的节点,右子节点就是下标为 i∗2+1 的节点,父节点就是下标为 i/2 的节点。
知道了如何存储一个堆,那我们再来看看,堆上的操作有哪些呢?罗列了几个非常核心的操作,分别是往堆中插入一个元素和删除堆顶元素。
从堆中插入一个元素
往堆中插入一个元素后,我们需要继续满足堆的两个特性。
如果我们把新插入的元素放到堆的最后,你可以看我画的这个图,是不是不符合堆的特性了?
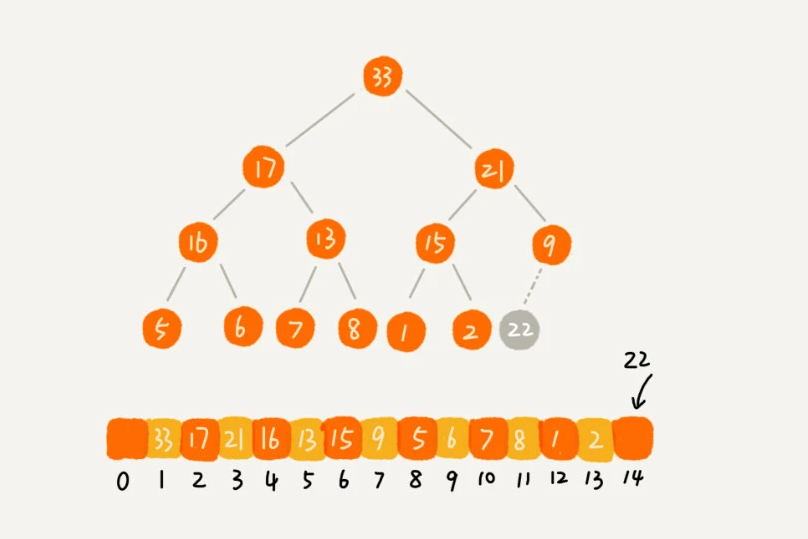
于是,我们就需要进行调整,让其重新满足堆的特性,这个过程我们起了一个名字,就叫做堆化(heapify)。
堆化实际上有两种,从下往上和从上往下。这里我先讲从下往上的堆化方法。
堆化非常简单,就是顺着节点所在的路径,向上或者向下,对比,然后交换。
我们可以让新插入的节点与父节点对比大小。如果不满足子节点小于等于父节点的大小关系,我们就互换两个节点。一直重复这个过程,直到父子节点之间满足刚说的那种大小关系。
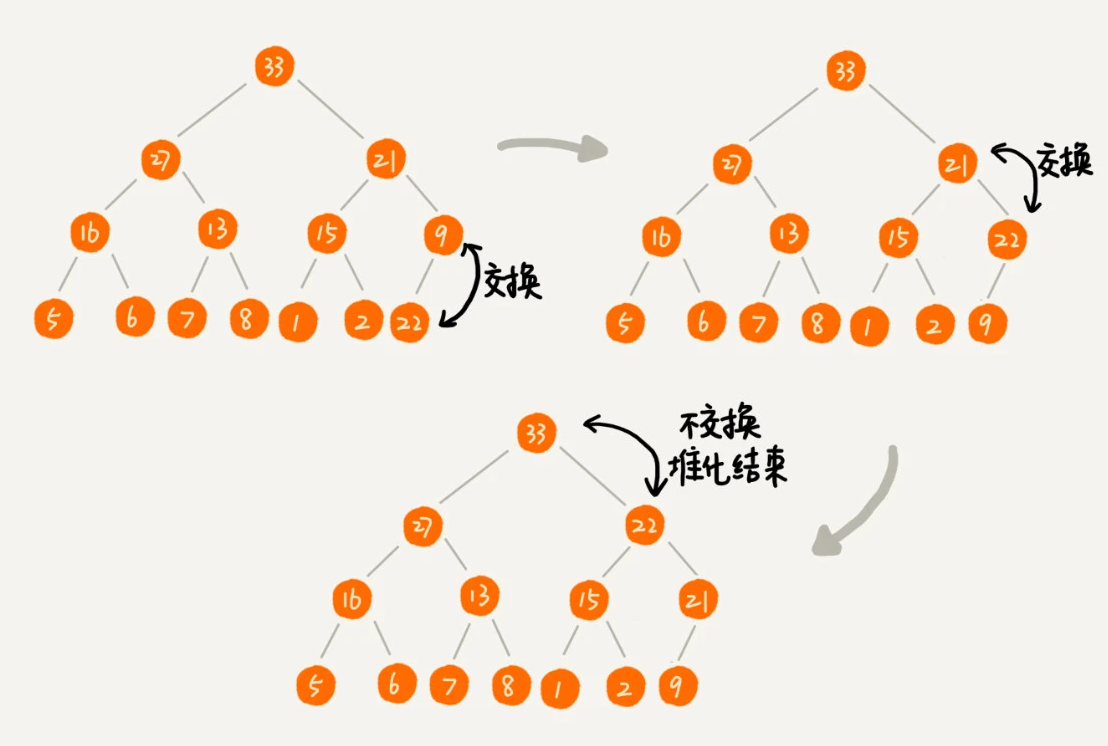
1 | |
删除堆顶元素
从堆的定义的第二条中,任何节点的值都大于等于(或小于等于)子树节点的值,我们可以发现,堆顶元素存储的就是堆中数据的最大值或者最小值。
假设我们构造的是大顶堆,堆顶元素就是最大的元素。当我们删除堆顶元素之后,就需要把第二大的元素放到堆顶,那第二大元素肯定会出现在左右子节点中。然后我们再迭代地删除第二大节点,以此类推,直到叶子节点被删除。
这里我也画了一个分解图。不过这种方法有点问题,就是最后堆化出来的堆并不满足完全二叉树的特性。
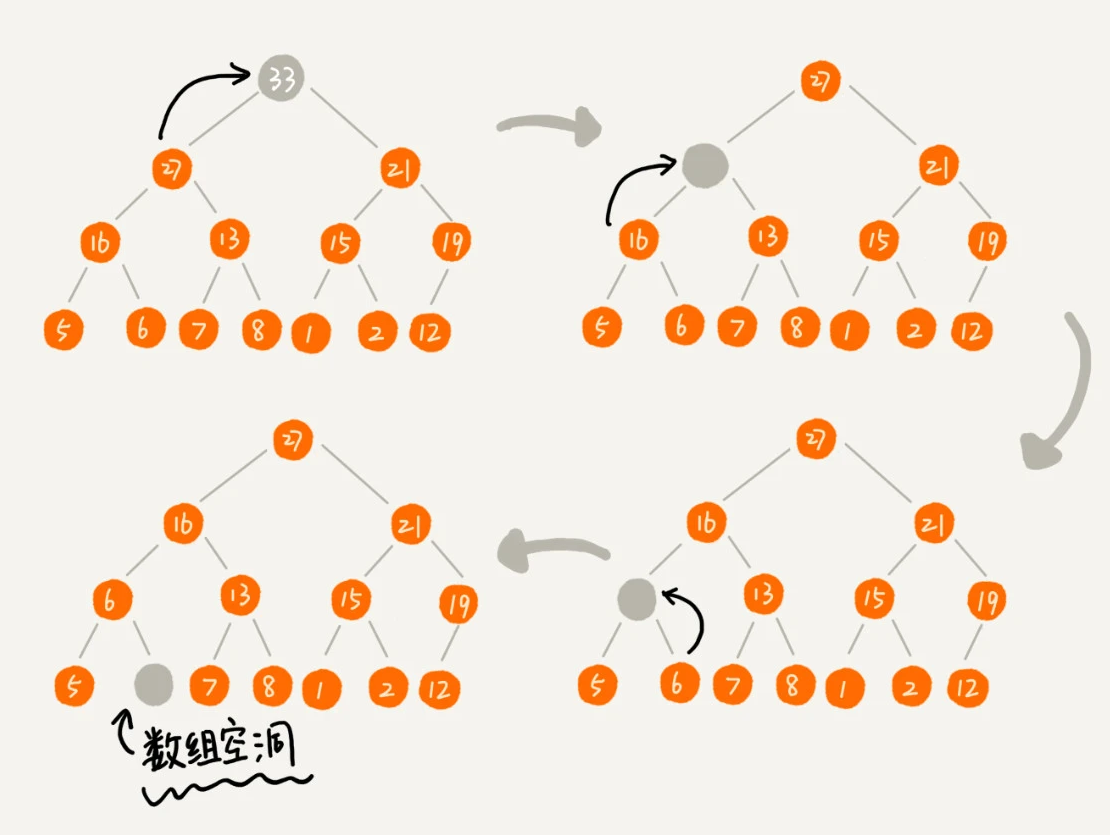
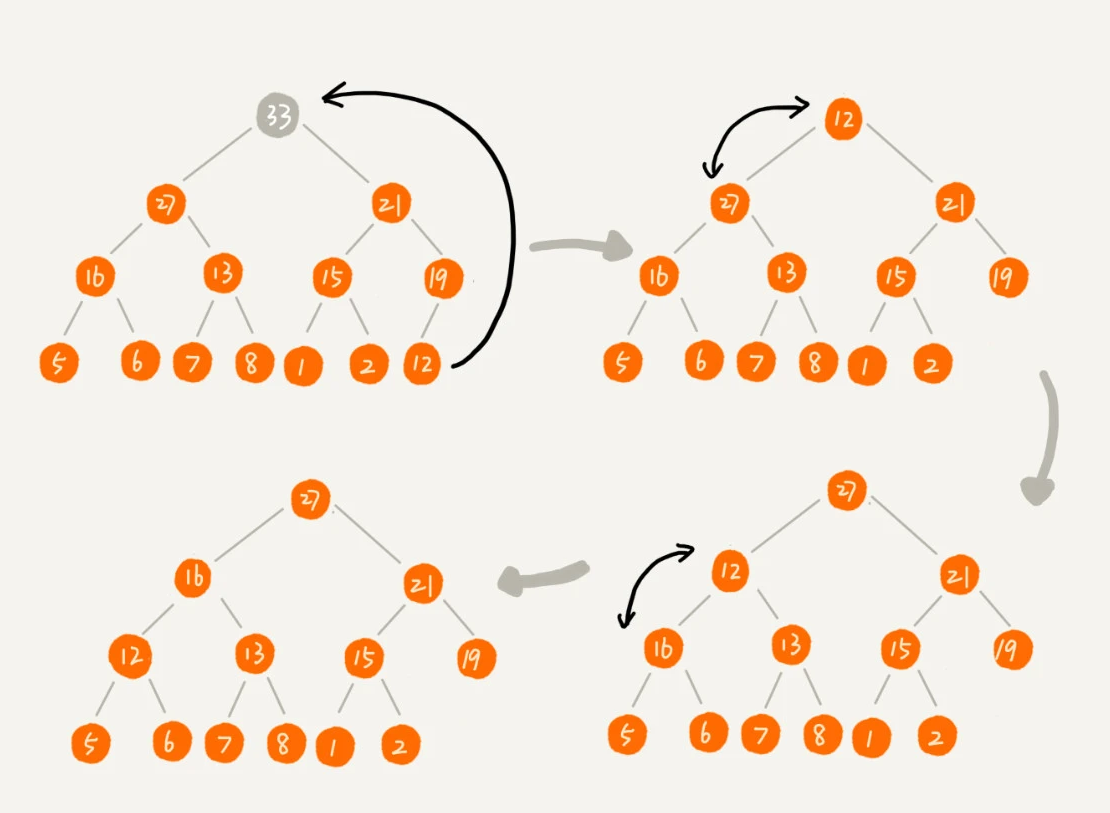
实际上,我们稍微改变一下思路,就可以解决这个问题。你看我画的下面这幅图。我们把最后一个节点放到堆顶,然后利用同样的父子节点对比方法。对于不满足父子节点大小关系的,互换两个节点,并且重复进行这个过程,直到父子节点之间满足大小关系为止。这就是从上往下的堆化方法。
因为我们移除的是数组中的最后一个元素,而在堆化的过程中,都是交换操作,不会出现数组中的“空洞”,所以这种方法堆化之后的结果,肯定满足完全二叉树的特性。
1 | |
我们知道,一个包含 n 个节点的完全二叉树,树的高度不会超过 log2n。堆化的过程是顺着节点所在路径比较交换的,所以堆化的时间复杂度跟树的高度成正比,也就是 O(logn)。插入数据和删除堆顶元素的主要逻辑就是堆化,所以,往堆中插入一个元素和删除堆顶元素的时间复杂度都是 O(logn)。