断言
什么是断言?
简单来说,断言是指对匹配到的文本位置有要求。
\d{11} 能匹配上 11 位数字,但这 11 位数字可能是 18 位身份证号中的一部分。再比如,去查找一个单词,我们要查找 tom,但其它的单词,比如 tomorrow 中也包含了 tom。
也就是说,在有些情况下,我们对要匹配的文本的位置也有一定的要求。为了解决这个问题,正则中提供了一些结构,只用于匹配位置,而不是文本内容本身,这种结构就是断言。常见的断言有三种:单词边界、行的开始或结束以及环视。
- 单词边界
- 行的开始/结束
- 环视
单词边界
在讲单词边界具体怎么使用前,先来看一下例子。我们想要把下面文本中的 tom 替换成 jerry。注意一下,在文本中出现了 tomorrow 这个单词,tomorrow 也是以 tom 开头的。
1 | |
利用前面学到的知识,我们如果直接替换 ,会出现下面这种结果。
1 | |
那正则是如何解决这个问题的呢?
单词的组成一般可以用元字符 \w+ 来表示,\w 包括了大小写字母、下划线和数字(即 [A-Za-z0-9_])。那如果我们能找出单词的边界,也就是当出现了 \w 表示的范围以外的字符,比如引号、空格、标点、换行等这些符号,我们就可以在正则中使用 \b 来表示单词的边界。 \b 中的 b 可以理解为是边界(Boundary)这个单词的首字母。
tom,单词包含 tom |
\btom,以 tom 开头的单词 |
tom\b,以 tom 结尾的单词 |
\btom\b,只能是 tom |
|
|---|---|---|---|---|
| tom | √ | √ | √ | √ |
| tomorrow | √ | √ | x | x |
| atom | √ | x | √ | x |
| atomic | √ | x | x | x |
根据上面的例子,就可以以下的正则表达式去应用
1 | |
行的开始或结束
和单词的边界类似,在正则中还有文本每行的开始和结束,如果我们要求匹配的内容要出现在一行文本开头或结尾,就可以使用 ^ 和 $ 来进行位置界定。
先说一下行的结尾是如何判断的。你应该知道换行符号。在计算机中,回车(\r)和换行(\n)其实是两个概念,并且在不同的平台上,换行的表示也是不一样的。在这里列出了 Windows、Linux、macOS 平台上换行的表示方式。
| 平台 | 换行符号 |
|---|---|
| Windows | \r\n |
| Linux | \n |
| macOS | \n |
应用:输入数据校验
在 Web 服务中,我们常常需要对输入的内容进行校验,比如要求输入 6 位数字,我们可以使用 \d{6} 来校验。但你需要注意到,如果用户输入的是 6 位以上的数字呢?
在这种情况下,如果不去要求用户录入的 6 位数字必须是行的开头或结尾,就算验证通过了,结果也可能不对。比如下面的示例,在不加行开始和结束符号时,用户输入了 7 位数字,也是能校验通过的:
| 正则表达式 | 数据 | 匹配结果 |
|---|---|---|
\d{6} |
1234567 | 匹配成功,包含 6 位数字 |
^\d{6} |
1234567 | 匹配成功,6 位数字开头 |
\d{6}$ |
1234567 | 匹配成功,6 位数字结尾 |
^\d{6}$ |
1234567 | 匹配失败,只能是 6 位数字 |
^\d{6}$ |
123456 | 匹配成功 |
环视
环视就是要求匹配部分的前面或后面要满足(或不满足)某种规则,有些地方也称环视为零宽断言。
那具体什么时候我们会用到环视呢?
举个例子。邮政编码的规则是由 6 位数字组成。现在要求你写出一个正则,提取文本中的邮政编码。根据规则,我们很容易就可以写出邮编的组成 \d{6}。我们可以使用下面的文本进行测试:
1 | |
测试发现,7 位数的前 6 位也能匹配上,12 位数匹配上了两次,这显然是不符合要求的。
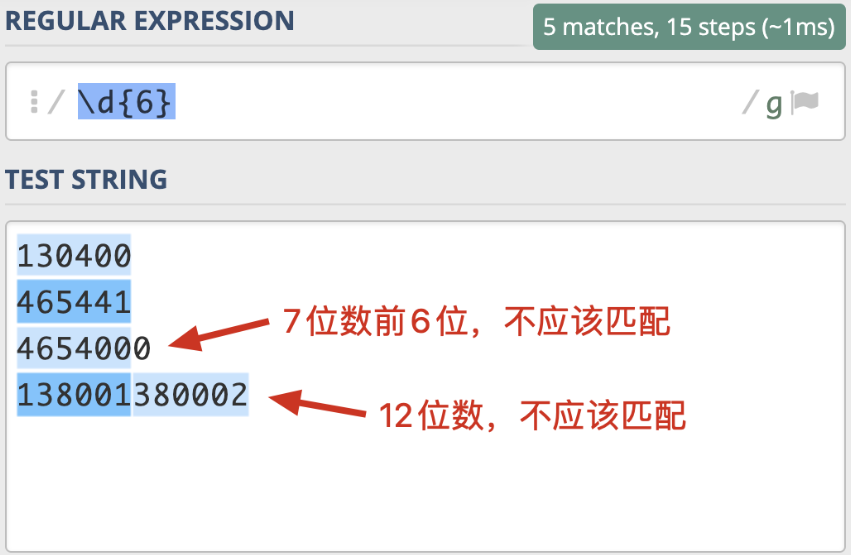
也就是说,除了文本本身组成符合这 6 位数的规则外,这 6 位数左边或右边都不能是数字。
正则是通过环视来解决这个问题的。解决这个问题的正则有四种:
| 正则 | 名称 | 含义 | 示例 |
|---|---|---|---|
(?<=Y) |
肯定逆序环视 | 左边是 Y | (?<=\d)th,该正则匹配左边是数字的 th,例如:9th |
(?!Y) |
否定逆序环视 | 左边不是 Y | (?!\d)th,该正则匹配左边不是数字的 th,例如:health |
(?=Y) |
肯定顺序环视 | 右边是 Y | six(?=\d),该正则匹配 six 右边是数字,例如:six6 |
(?!Y) |
否定顺序环视 | 右边不是 Y | hi(?!\d),该正则匹配 hi 右边不是数字,例如:high |
可能觉得名称比较难记住,这里有一个小口诀,只要记住了它的功能和写法就行。
这个小口诀可以在心里默念几遍:左尖括号代表看左边,没有尖括号是看右边,感叹号是非的意思。
需要注意的是,环视中虽然也有括号,但不会保存成分组。
保存成子组的一般是匹配到的文本内容,后续用于替换等操作,而环视是表示对文本左右环境的要求,即环视只匹配位置,不匹配文本内容。
小结
总结回顾一下,最常见的断言有三种:单词的边界、行的开始或结束、环视。
单词的边界是使用 \b 来表示,这个比较简单。而多行模式下,每一行的开始和结束是使用 ^ 和 $ 符号。如果想匹配整个字符串的开始或结束,可以使用 \A 和 \z,它们不受匹配模式的影响。
最后就是环视,它又分为四种情况:肯定逆向环视、否定逆向环视、肯定顺序环视、否定顺序环视。在使用的时候记住一个方法:有左尖括号代表看左边,没有尖括号是看右边,而感叹号是非的意思。